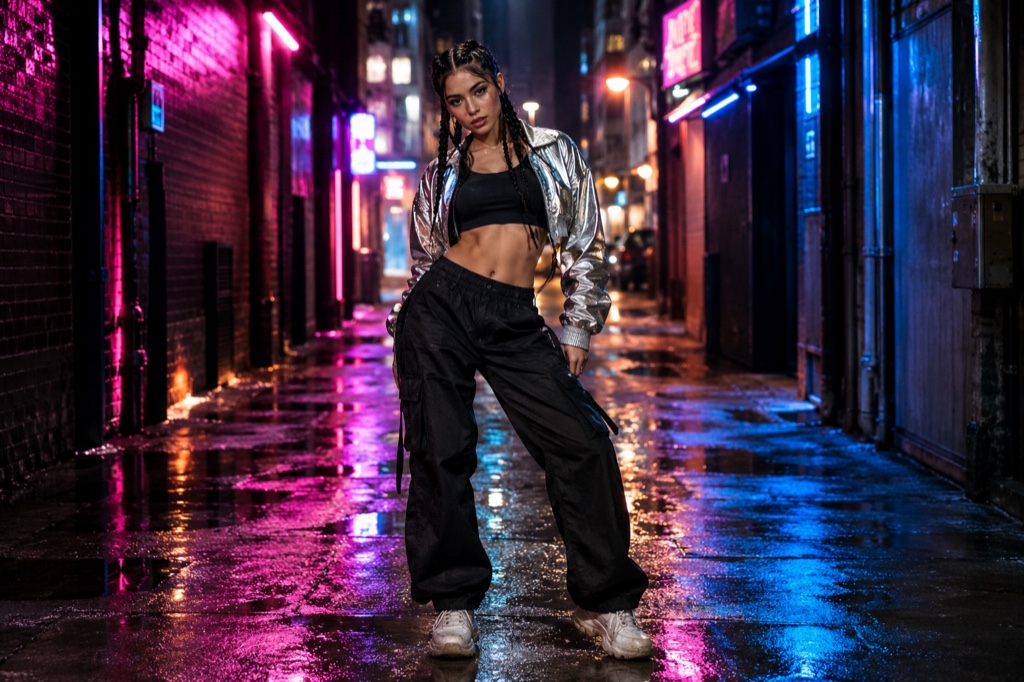
Tekst-naar-dansmodus · geen foto nodig

Tekst-naar-dansvideo: beschrijf een personage, render een dansclip

De tekst-naar-dansmodus draait de gebruikelijke workflow om. In plaats van een foto te uploaden en te hopen dat het model het gezicht behoudt, typ je een personagebeschrijving — leeftijdsrange, postuur, haar, outfit, attitude — plus de scène die je eromheen wilt. De render maakt van die beschrijving een korte verticale clip van een figuur die de hero point uit de Looks Can Kill-choreografie raakt. Geen selfie, geen stap om foto's op te schonen, geen giswerk welke upload de render overleeft.

De trend zelf is door fans gemaakt. Toen IVE 'Looks Can Kill' uitbracht als titeltrack van hun vijfde EP — single op 19 oktober 2026, EP op 26 oktober 2026 — zorgden het girlhero-concept en de vingerpistool-point ervoor dat mensen zichzelf in één take filmden. Tekst-naar-dans behoudt de vorm van die clip maar laat de bronfoto weg: je verzint iemand die niet bestaat en zet die in een scène die je nooit zou kunnen schieten.

De clips op deze pagina zijn door AI gegenereerde previews. Ze zijn fictief en geen verslag van een echte gebeurtenis.

Bijgewerkt op 20 oktober 2026

Verticale dansclip gegenereerd in tekst-naar-dansmodus op basis van een geschreven personagebeschrijving
Lengte
5–12 seconden
Resolutie
480p · 720p · 1080p
Beeldverhouding
9:16 · 16:9 · 1:1
Watermerk
Geen bij betaalde renders
Model
Seedance 2.0
Moderatie
SeeAPI, fail-closed

Geen foto, geen gezichtsdrift

In de fotorodus moet het model een geüpload gezicht consistent houden over de frames. Tekst-naar-dans bouwt de figuur vanuit de beschrijving, dus er is geen gezicht dat kan verschuiven — maar de beschrijving moet de hele look dragen, van silhouet tot outfitkleur.

Geframed voor de hero point

Standaardoutput is 9:16 verticaal en 12 seconden, wat past bij de vingerpistool-point in de 'Looks Can Kill'-choreografie: een tel aanloop, één scherp gebaar, een korte staart. Je kunt benoemen waar in de clip de point valt.

Credits, gewoon geprijsd

Credits beginnen bij $9.90. Een standaardclip van 12 seconden in 720p kost 35 credits, dus een kleine opwaardering dekt een paar takes. Mislukte renders worden terugbetaald — je betaalt niet voor een clip die nooit is geleverd.

Hoe het werkt

  1. 1

    Schakel over naar tekst-naar-dans

    Open de studio en kies het tabblad tekst-naar-dans in plaats van fotoupload. Je krijgt twee promptvelden: personage en scène. Er wordt niets geüpload, dus niets hoeft eerst te worden bijgesneden of opnieuw belicht.

  2. 2

    Schrijf het personage

    Lengte, postuur, haarlengte, één sterke outfitkleur, één attitudecue. Bijvoorbeeld: 'een lange danser in een kort rood jasje en zwarte wijdvallende broek, kin omhoog, uitdrukkingsloos.' Houd de persoon verzonnen — alleen fictieve personages.

  3. 3

    Schrijf de scène en de camera

    Benoem de locatie, het licht en de framing: 'leeg perron van de metro, hard toplicht, langzame push-in, verticaal 9:16.' Zeg waar de point valt — openingsseconde of halverwege — zodat het gebaar niet begraven wordt.

  4. 4

    Render en check

    Render een standaardclip van 12 seconden in 720p voor 35 credits; credits beginnen bij $9.90. Als de render mislukt, komen de credits terug op je saldo en kun je de prompt aanscherpen en opnieuw proberen.

Begin met een getest prompt

Elk prompt is compleet: onderwerp, scène, camera en wat niet mag veranderen. Kopieer het of open de studio ermee.

Een beschreven personage in een kort rood jasje midden in een vingerpistool-point in een neonverlichte gang, gerenderd als 9:16-dansclip

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (Engels)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Gebruik in studio

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (Engels)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Gebruik in studio

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (Engels)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Gebruik in studio

Hoe tekst-naar-dans een clip rendert

Tekst-naar-dans slaat de uploadfase over. Je prompt wordt gelezen als drie slots — onderwerp, setting, actie — en het model bouwt één consistente figuur over de volle 12 seconden in plaats van elk frame opnieuw een gezicht te raden. Daarom is de kwaliteit van de beschrijving hier belangrijker dan in de fotorodus: niets wordt vastgepind door een referentiebeeld.

Een standaardrender is 720p, 9:16 verticaal, 12 seconden — de vorm van een Reels- of TikTok-upload. Langere of scherpere output kost meer credits. Een mislukte render wordt terugbetaald, dus een slechte take vreet je saldo niet stilletjes aan.

Wat er in een personagebeschrijving hoort

Begin met silhouet, niet met detail. Lengte, postuur, haarlengte en één sterke outfitkleur lezen direct op 720p; zes accessoires vervagen tot ruis op dat formaat.

Geef dan één houding waar de choreografie uit kan schieten — kin omhoog, losse schouders, uitdrukkingsloos. De hero point is een kort, scherp gebaar, dus het model heeft een stance nodig om uit te breken, geen persoonlijkheidsessay.

Houd het personage fictief. Beschrijf verzonnen mensen; vraag niet om een echte artiest, een IVE-lid of iemands gelijkenis.

Credits, prijzen en wat een clip echt kost

Credits beginnen bij $9.90. Een standaardclip van 12 seconden in 720p kost 35 credits, dus een bescheiden opwaardering koopt een eerste poging en een reshoot zonder dat je vastzit aan een abonnement dat je vergeet op te zeggen.

Mislukte renders worden terugbetaald op je saldo, dus je betaalt voor geleverde clips in plaats van wachtrijtijd. Er wordt nergens in de pipeline gebruikgemaakt van officiële opnames, muziekvideobeelden of gelijkenissen van leden — de output is een beschreven, verzonnen personage.

Veelgestelde vragen

Heb ik een foto nodig om een tekst-naar-dansclip te maken?

Nee. De tekst-naar-dansmodus neemt een geschreven personagebeschrijving en een scène in plaats van een upload. De fotorodus bestaat nog als je liever met een selfie begint — deze pagina behandelt de route zonder foto.

Wat kost een clip?

Credits beginnen bij $9.90. Een standaard verticale clip van 12 seconden in 720p kost 35 credits. Mislukte renders worden terugbetaald op je saldo, dus een fout kost je geen credits.

Zit de officiële 'Looks Can Kill'-audio erbij?

Nee. Er wordt geen officiële opname, muziekvideobeeld of gelijkenis van een lid gebruikt. Clips zijn stil of bevatten de audio die je later in je eigen editor toevoegt.

Kan ik een echt persoon beschrijven, zoals een IVE-lid?

Nee. Tekst-naar-dans is voor fictieve personages. Prompts die echte artiesten noemen of om de gelijkenis van een specifieke idol vragen, worden niet ondersteund; de trend waar deze site op reageert is door fans gemaakt en niet verbonden.

Hoe lang en hoe scherp is de output?

Standaardrenders zijn 12 seconden in 720p in een verticaal 9:16-frame — genoeg voor één volledige hero-point-pass met een tel aanloop. Langere of hogeresolutierenders kosten meer credits.

Is Looks Can Kill AI officieel?

Nee. Het is een onafhankelijke studio, niet verbonden aan IVE of Starship Entertainment. 'Looks Can Kill' is de titeltrack van IVE's vijfde EP, met de single op 19 oktober 2026 en de EP op 26 oktober 2026; deze tool reageert alleen op de door fans gemaakte dans-trend eromheen.

Maak van je foto een clip

Begin met de preset op deze pagina of schrijf je eigen shot. Credits worden getoond voor je genereert en mislukte renders worden terugbetaald.