文本生成舞蹈模式 · 无需照片

文本生成舞蹈视频:描述角色,渲染舞蹈片段

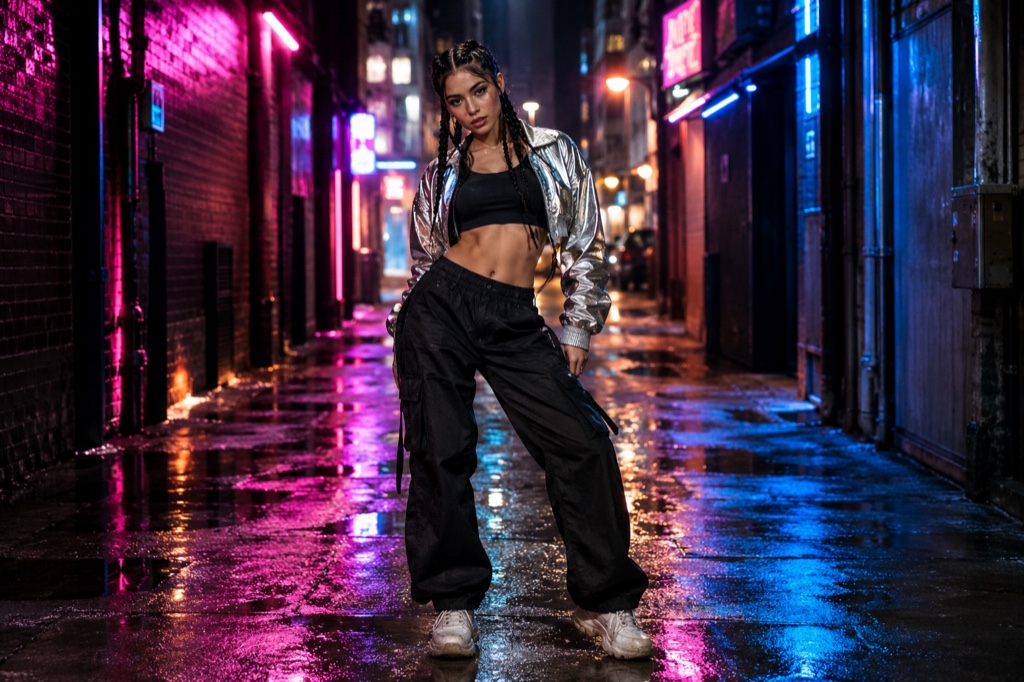
文本生成舞蹈模式颠覆了通常流程。你不用上传照片再祈祷模型保住脸,而是输入角色描述——年龄段、体型、发型、服装、气质——再加上你想要的环境场景。渲染会把这段描述变成一段竖屏短片,人物做出 Looks Can Kill 编舞里的 hero point。不用自拍,不用清理照片,也不用猜哪张上传能撑过渲染。

这个趋势本身是粉丝自制的。IVE 发布第五张 EP 主打歌“Looks Can Kill”——单曲于 2026 年 10 月 19 日发行,EP 于 2026 年 10 月 26 日发行——girl-hero 概念和手指枪指向动作让人们一镜到底自拍。文本生成舞蹈保留了那种片段形态,但省掉源照片:你创造不存在的人,并把他们放进你平时根本拍不到的场景。

本页短片均为 AI 生成的预览,属于虚构内容,不是真实事件的记录。

更新于 2026 年 10 月 20 日

在文本生成舞蹈模式下,根据文字角色描述生成的竖屏舞蹈片段
时长
5–12 秒
分辨率
480p · 720p · 1080p
画面比例
9:16 · 16:9 · 1:1
水印
付费成片无水印
模型
Seedance 2.0
内容审核
SeeAPI,失败即拦截

无需照片,没有人脸漂移

在照片模式里,模型必须让上传的脸在每一帧保持一致。文本生成舞蹈则根据描述构建人物,所以不存在人脸漂移——但描述必须承载完整造型,从轮廓到服装颜色。

为 hero point 构图

默认输出为 9:16 竖屏、12 秒,正好适合“Looks Can Kill”编舞里的手指枪指向:一拍引入、一个干脆手势、短收尾。你可以指定指向动作落在片段中的哪个位置。

积分,价格清楚

积分 $9.90 起。标准 720p、12 秒片段消耗 35 积分,小额充值就能覆盖几次尝试。渲染失败会退回——没有交付的片段不会收费。

使用步骤

  1. 1

    1. 切换到文本生成舞蹈

    打开工作室,选择文本生成舞蹈标签,而不是照片上传。你会看到两个提示词字段:角色和场景。无需上传任何内容,所以也不用先裁剪或重新打光。

  2. 2

    2. 写角色

    身高、体型、发长、一个鲜明的服装颜色、一个气质提示。例如:“一位高个子舞者,穿短款红色夹克和黑色阔腿裤,下巴微抬,面无表情。”人物必须是虚构的——仅限虚构角色。

  3. 3

    3. 写场景和镜头

    写明地点、光线和构图:“空旷地铁站台,硬顶光,缓慢推近,竖屏 9:16。”说明指向动作落在哪里——开头一秒还是中段——这样手势才不会被埋没。

  4. 4

    4. 渲染并检查

    用 35 积分渲染标准 720p、12 秒片段;积分 $9.90 起。如果渲染失败,积分会退回余额,你可以收紧提示词再试。

从经过测试的提示词开始

每条提示词都是完整的:主体、场景、镜头,以及必须保持不变的部分。可以复制,也可以直接带入工作台。

描述中的角色身穿短款红色夹克,在霓虹灯走廊中做手指枪指向动作,渲染为 9:16 舞蹈片段

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

提示词(英文)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

在工作台使用

Comic frame

A comic frame scene with a tighter camera and a held final pose.

提示词(英文)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

在工作台使用

Practice room

A practice room scene for a more graphic, stylised result.

提示词(英文)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

在工作台使用

文本生成舞蹈如何渲染片段

文本生成舞蹈跳过图片上传阶段。你的提示词会被读取为三个槽位——主体、场景、动作——模型会在完整 12 秒里构建一个一致的人物,而不是每一帧重新猜一张脸。这就是为什么这里的描述质量比照片模式更重要:没有参考图来锁定任何东西。

标准渲染为 720p、9:16 竖屏、12 秒——正是 Reels 或 TikTok 上传的形态。更长或更清晰的输出会消耗更多积分。渲染失败会退回,所以糟糕的尝试不会悄悄吃掉你的余额。

角色描述里应该写什么

先写轮廓,不写细节。身高、体型、发长和一个鲜明的服装颜色在 720p 下能立刻读出来;六个配饰在这种尺寸下会糊成噪音。

然后给出一个编舞能从中迅速切换的站姿——下巴微抬、肩膀放松、面无表情。hero point 是短促、干脆的手势,所以模型需要一个可打破的站姿,而不是一篇性格小论文。

保持角色虚构。描述虚构人物;不要要求真实表演者、IVE 成员或任何人的肖像。

积分、定价,以及一段剪辑实际花多少

积分 $9.90 起。标准 720p、12 秒片段消耗 35 积分,所以适度充值就能买一次首试和一次重拍,而不用承诺一个你会忘记取消的订阅。

渲染失败会退回余额,所以你为交付的片段付费,而不是排队时间。整个流程中不使用官方录音、音乐视频素材或成员肖像——输出的是被描述出来的虚构角色。

常见问题

制作文本生成舞蹈片段需要照片吗?

不需要。文本生成舞蹈模式接收文字角色描述和场景,而不是上传文件。如果你更想从自拍开始,照片模式仍然存在——本页讲的是无照片路径。

一段剪辑要花多少?

积分 $9.90 起。标准 720p、12 秒竖屏片段消耗 35 积分。渲染失败会退回余额,所以出错不会消耗积分。

会包含官方“Looks Can Kill”音频吗?

不会。不使用任何官方录音、音乐视频素材或成员肖像。片段本身无声,或带上你之后在自己的编辑器里添加的音频。

我可以描述真实人物,比如 IVE 成员吗?

不可以。文本生成舞蹈只用于虚构角色。不支持点名真实表演者或要求特定偶像肖像的提示词;本网站响应的趋势是粉丝自制且无关联的。

输出多长、多清晰?

标准渲染为 12 秒、720p、9:16 竖屏画幅——足够完成一次完整的 hero-point 动作,并带一拍引入。更长或更高分辨率的渲染会消耗更多积分。

Looks Can Kill AI 是官方产品吗?

不是。它是一个独立工作室,与 IVE 或 Starship Entertainment 无关联。“Looks Can Kill”是 IVE 第五张 EP 的主打歌,单曲于 2026 年 10 月 19 日发行,EP 于 2026 年 10 月 26 日发行;本工具只响应围绕它的粉丝自制舞蹈趋势。

把你的照片变成短片

从本页的预设开始,或写你自己的镜头。生成前会显示所需积分,失败会自动退回。