Fan-made · unabhängig · nicht mit IVE oder Starship verbunden

Kpop Dance AI: Die visuelle Sprache der K-Pop-Point-Choreografie, übersetzt in ein einziges Foto

K-Pop-Point-Choreografie ist für die zweite Kamera gebaut. Ein Shoulder-Lock, ein schneller Handgelenks-Snap, eine Finger-Gun direkt in die Linse – die Bewegung, die ein Fancam drei Wochen lang loopt. IVEs „Looks Can Kill“ setzt mit seinem Girl-Hero-Konzept stark auf diese Logik, und der Fan-Trend darum ist noch einfacher: ein Foto rein, ein kurzer vertikaler Clip raus, in dem du den Hero-Point triffst. Keine Routine zum Auswendiglernen, keine Gruppe zum Synchronisieren.

Was folgt, ist eine Aufschlüsselung dieser visuellen Grammatik – klare Linien im Bild, Hit-and-Hold-Timing, die Hero-Silhouette – und wie ein Ein-Foto-Workflow sie ohne Tanzstudio reproduziert. Du lädst ein Bild hoch, beschreibst die Hero-Point-Bewegung in Text, und das Studio rendert einen vertikalen 12-Sekunden-Clip in 720p für 35 Credits. Credits starten bei $9.90, fehlgeschlagene Renderings werden erstattet, und nichts hier verwendet die offizielle Aufnahme oder Abbildungen der Mitglieder.

Die Clips auf dieser Seite sind KI-generierte Vorschauen. Sie sind fiktiv und kein Beleg für ein reales Ereignis.

Aktualisiert am 20. Oktober 2026

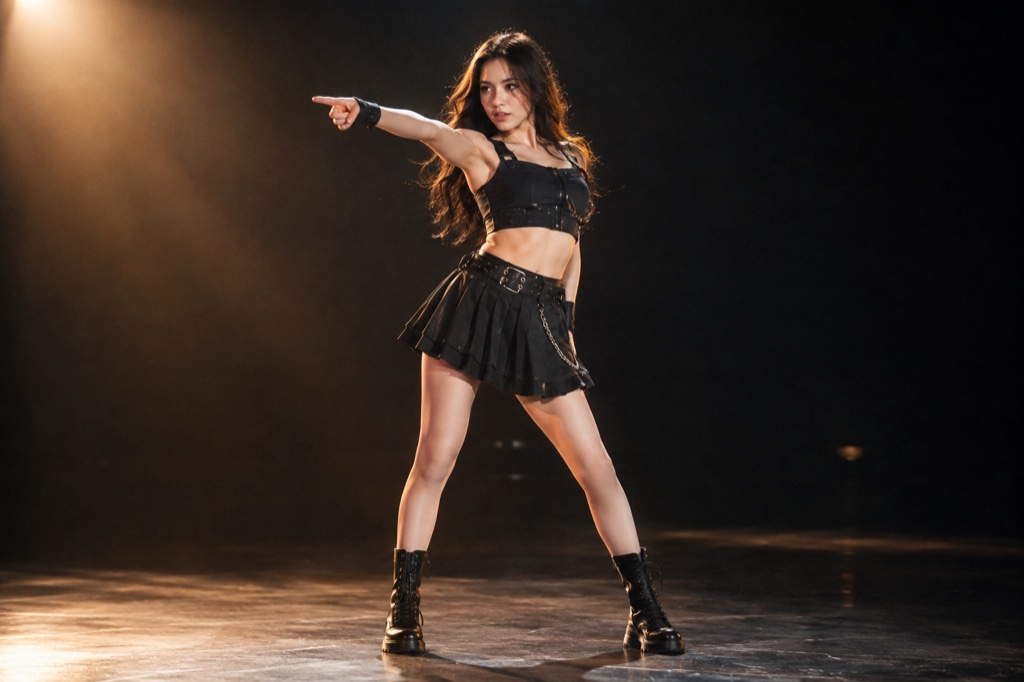
Vertikaler 9:16-Frame einer tanzenden Person mitten im Hero-Point, ein Arm in einer Finger-Gun-Geste zur Kamera gestreckt, von vorne beleuchtet vor einem dunklen Bühnenboden
Länge
5–12 Sekunden
Auflösung
480p · 720p · 1080p
Seitenverhältnis
9:16 · 16:9 · 1:1
Wasserzeichen
Keines bei bezahlten Renderings
Modell
Seedance 2.0
Moderation
SeeAPI, fail-closed

Die Point-Move ist die Einheit, nicht die Routine

Dieses Studio versucht nicht, eine komplette dreißigsekündige Sequenz zu rekonstruieren. Es zielt auf die Geste, die den Song trägt – bei „Looks Can Kill“ der Finger-Gun-Hero-Point – und hält sie lange genug, um auf einem Smartphone-Display in Armlänge lesbar zu sein.

Ein Bild, kein Referenzvideo

Du lädst kein Filmmaterial von dir beim Tanzen hoch und gleichst kein Fancam eines Mitglieds Frame für Frame ab. Ein einzelnes klares Foto plus eine kurze Textbeschreibung der Bewegung sind der gesamte Input. Das Foto liefert Körper, Outfit und Licht; der Text liefert die Bewegung.

Pro Clip bepreist, bei Fehlschlag erstattet

Ein Standard-Clip in 720p mit 12 Sekunden kostet 35 Credits, und Credits starten bei $9.90. Wenn ein Rendering fehlschlägt, gehen diese Credits auf dein Guthaben zurück – du zahlst für brauchbaren Output, nicht für Versuche.

So funktioniert es

  1. 1

    Lade ein Foto hoch

    Wähle eine scharfe Ganzkörper- oder Dreiviertelaufnahme, auf der deine Hände sichtbar und nicht abgeschnitten sind. Gleichmäßiges Frontlicht und ein schlichter Hintergrund geben dem Modell eine sauberere Silhouette zum Animieren als eine unruhige Szene oder ein Selfie aus der Froschperspektive.

  2. 2

    Beschreibe den Hero-Point

    Beschreibe die Geste so, wie eine Choreografin sie ansagen würde: welcher Arm zur Linse schnellt, wo das Handgelenk snappt, ob die Brust geöffnet und das Kinn gesenkt ist, wie weit sich die Schultern beim Hit drehen. Zwei oder drei konkrete Zeilen schlagen einen Absatz voller Stimmungswörter.

  3. 3

    Rendere den 12-sekündigen Clip

    Das Studio erzeugt ein vertikales Video in 720p und 9:16 – der native Zuschnitt für den Trend – für 35 Credits pro Standard-Rendering. Kein Timeline-Editing, keine Keyframes, keine zweite App.

  4. 4

    Prüfen und erneut rendern

    Achte zuerst auf Hände, Handgelenke und Haaransatz; dort bricht Image-to-Video typischerweise. Wenn ein Durchlauf komplett fehlschlägt, werden die Credits erstattet. Wenn er rendert, die Geste aber weich wirkt, schärfe die Beschreibung und starte erneut.

Mit einem getesteten Prompt starten

Jeder Prompt ist vollständig: Motiv, Szene, Kamera und was sich nicht ändern darf. Kopiere ihn oder öffne das Studio damit.

Beispiel nebeneinander: links ein einzelnes hochgeladenes Porträt, rechts der generierte vertikale 12-Sekunden-Clip in 720p, mitten in der Point-Choreografie eingefangen

Spotlight finale

A spotlight finale scene that keeps the face and outfit from your photo.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A dark stage with a single warm spotlight and a thin haze in the air. The person steps into the light, crosses their arms, snaps a finger-gun point at the lens, shifts through a side step, lifts a bent leg and finishes with an arm overhead and a held final pose as the light tightens on them. One continuous vertical 9:16 shot at full-body distance, slow push-in, deep shadows and warm rim light. No text, no watermark, no other people, no real celebrities, no logos.

Im Studio verwenden

Practice room

A practice room scene with a tighter camera and a held final pose.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Im Studio verwenden

Comic frame

A comic frame scene for a more graphic, stylised result.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Im Studio verwenden

Was K-Pop-Point-Choreografie auf dem Smartphone lesbar macht

Point-Choreografie ist eine Kompressionsgewohnheit. Ein Titeltrack ist um zwei oder drei Gesten herum gebaut, die einen 9:16-Zuschnitt überleben: eine klare Linie von der Schulter bis zur Fingerspitze, ein Hit, der auf dem Vocal-Chop landet, eine Silhouette, die ein Zuschauer im Schlafzimmerspiegel nachmachen kann. Alles andere ist Bindegewebe.

„Looks Can Kill“ hebt das in ein Girl-Hero-Register – Kinn unten, Brust offen, Finger-Gun auf die Linse gerichtet. Die Geste ist in einem einzelnen Standbild lesbar, und genau deshalb kann ein Ein-Foto-Workflow sie reproduzieren, wo eine komplette Routine es nicht könnte.

Wie ein Standbild eine bewegte Geste trägt

Dein Foto beantwortet die statischen Fragen: Körperform, Kleidung, Haare, wo das Licht hinfällt, wie die Schultern sitzen. Der Text beantwortet die dynamischen: welcher Arm sich streckt, wie schnell das Handgelenk rotiert, ob das Gewicht beim Akzent auf den vorderen Fuß verlagert wird.

Den Clip auf zwölf Sekunden zu begrenzen, ist eine bewusste Einschränkung. Kurze Beats und ein enger vertikaler Ausschnitt halten das Bild auf dem Oberkörper, wo Point-Moves tatsächlich leben – und wo Gliedmaßen-Artefakte am unwahrscheinlichsten sichtbar werden.

Ehrliche Grenzen von fan-made K-Pop-Tanz-KI

Dies ist kein Tanz-Tutorial, keine offizielle Veröffentlichung und nicht mit IVE oder Starship Entertainment verbunden. Es enthält weder die offizielle Aufnahme noch das offizielle Video oder die Abbildung eines Mitglieds. Der Output ist eine stumme Videodatei; füge andernorts das Audio hinzu, für das du die Rechte hast.

Schnelle Handgelenksrotationen und überlappende Finger bleiben der fragile Teil jedes Image-to-Video-Modells. Starte mit einem Foto, auf dem die Hände bereits sichtbar und gut beleuchtet sind, halte die Geste langsam genug, um lesbar zu sein, und rechne mit einem zweiten Durchlauf, bevor der Point sauber sitzt.

Häufige Fragen

Ist das ein offizielles Tool von IVE oder Starship?

Nein. Looks Can Kill AI ist ein unabhängiges, fan-made Studio. Es steht in keiner Verbindung zu IVE oder Starship Entertainment, wird von dort nicht unterstützt und verwendet weder die offizielle Aufnahme noch das Musikvideo oder Abbildungen der Mitglieder.

Wird der Clip mit dem Audio von „Looks Can Kill“ ausgeliefert?

Es ist kein offizielles Audio enthalten. Du erhältst eine stumme vertikale Videodatei in 720p und kannst in deinem eigenen Editor den Sound hinzufügen, für den du die Rechte hast.

Wie viel kostet ein Clip tatsächlich?

Credits starten bei $9.90. Ein Standard-Clip in 720p mit 12 Sekunden kostet 35 Credits, und jedes Rendering, das fehlschlägt, wird deinem Guthaben erstattet – ein kaputter Output kostet dich also nie Credits.

Muss ich die Choreografie schon können?

Nein. Du beschreibst die Geste in einfachem Text – Armrichtung, Handgelenks-Snap, wohin du schaust – und das Studio übersetzt sie in Bewegung. Wenn du den Point kennst, hilft dir das, eine präzisere Beschreibung zu schreiben, aber du performst nie vor der Kamera.

Welches Foto liefert das beste Ergebnis?

Eine scharfe Ganzkörper- oder Dreiviertelaufnahme, sichtbare Hände, gleichmäßiges Frontlicht und ein Hintergrund, der nicht mit deiner Silhouette konkurriert. Verzichte auf extreme Winkel, abgeschnittene Hände und starke Bewegungsunschärfe; dort brechen Handgelenke und Finger zuerst.

Kann ich ein Foto eines IVE-Mitglieds oder einer befreundeten Person hochladen?

Lade nur Bilder hoch, für die du die Rechte hast – normalerweise deine eigenen. Abbildungen von Mitgliedern werden auf dieser Seite nirgends verwendet, und Clips von anderen Personen ohne deren Erlaubnis zu generieren, ist nicht der Zweck des Studios.

Mach aus deinem Foto einen Clip

Starte mit der Vorlage auf dieser Seite oder schreibe deine eigene Aufnahme. Die Credits werden vor dem Rendern angezeigt; fehlgeschlagene Renderings werden erstattet.