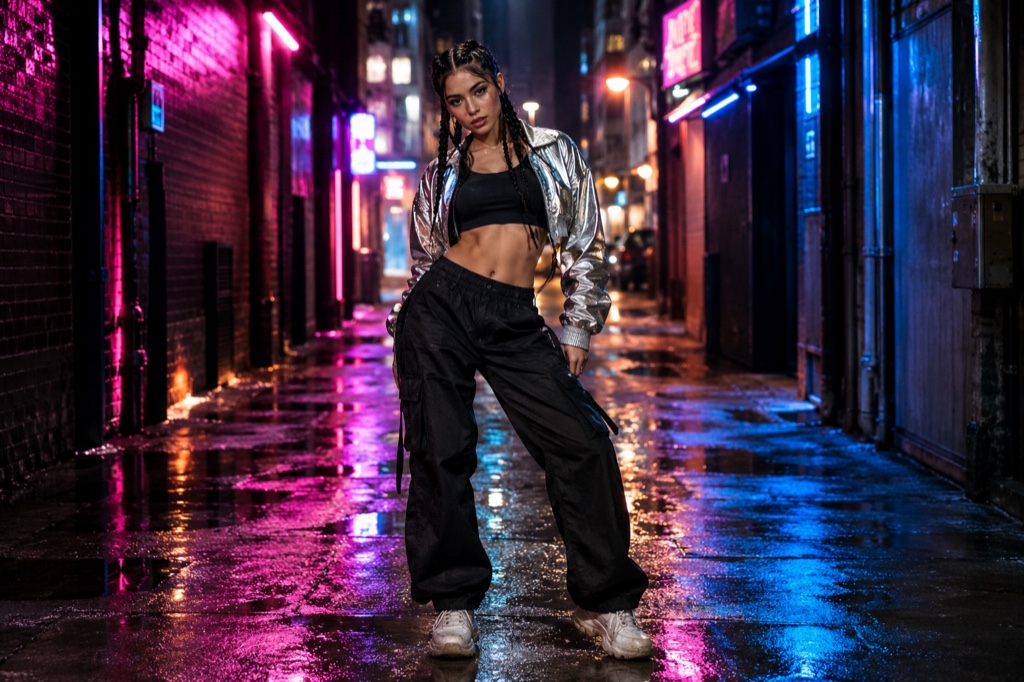
Text-to-Dance-Modus · kein Foto erforderlich

Text to Dance Video: Beschreibe eine Figur, rendere einen Tanzclip

Der Text-to-Dance-Modus dreht den üblichen Workflow um. Statt ein Foto hochzuladen und zu hoffen, dass das Modell das Gesicht beibehält, tippst du eine Figurenbeschreibung ein – Altersspanne, Statur, Haare, Outfit, Attitüde – plus die Szene, die du um sie herum willst. Das Rendering verwandelt diese Beschreibung in einen kurzen vertikalen Clip einer Figur, die den Hero-Point aus der „Looks Can Kill“-Choreografie trifft. Kein Selfie, kein Foto-Cleanup, kein Rätselraten, welcher Upload das Rendering übersteht.

Der Trend selbst ist Fan-made. Als IVE „Looks Can Kill“ als Titeltrack ihrer fünften EP veröffentlichte – Single am 19. Oktober 2026, EP am 26. Oktober 2026 – sorgten das Girl-Hero-Konzept und der Finger-Gun-Point dafür, dass Leute sich selbst in einem Take filmten. Text-to-Dance behält die Form dieses Clips bei, lässt aber das Ausgangsfoto weg: Du erfindest jemanden, den es nicht gibt, und setzt ihn in eine Szene, die du sonst nie drehen könntest.

Die Clips auf dieser Seite sind KI-generierte Vorschauen. Sie sind fiktiv und kein Beleg für ein reales Ereignis.

Aktualisiert am 20. Oktober 2026

Vertikaler Tanzclip, im Text-to-Dance-Modus aus einer geschriebenen Figurenbeschreibung generiert
Länge
5–12 Sekunden
Auflösung
480p · 720p · 1080p
Seitenverhältnis
9:16 · 16:9 · 1:1
Wasserzeichen
Keines bei bezahlten Renderings
Modell
Seedance 2.0
Moderation
SeeAPI, fail-closed

Kein Foto, kein Face-Drift

Im Foto-Modus muss das Modell ein hochgeladenes Gesicht über alle Frames konsistent halten. Text-to-Dance baut die Figur stattdessen aus der Beschreibung, also gibt es kein Gesicht, das driften kann – aber die Beschreibung muss den ganzen Look tragen, von der Silhouette bis zur Outfitfarbe.

Für den Hero-Point gerahmt

Die Standardausgabe ist vertikal 9:16 und 12 Sekunden, was zum Finger-Gun-Point in der „Looks Can Kill“-Choreografie passt: ein Beat Lead-in, eine scharfe Geste, ein kurzer Auslauf. Du kannst benennen, wo im Clip der Point landet.

Credits, klar bepreist

Credits starten bei $9.90. Ein Standard-Clip in 720p mit 12 Sekunden kostet 35 Credits, ein kleines Top-up deckt also ein paar Takes ab. Fehlgeschlagene Renderings werden erstattet – du zahlst nicht für einen Clip, der nie geliefert wurde.

So funktioniert es

  1. 1

    1. Wechsle zu Text-to-Dance

    Öffne das Studio und wähle den Text-to-Dance-Tab statt Foto-Upload. Du bekommst zwei Prompt-Felder: Figur und Szene. Nichts wird hochgeladen, also muss nichts vorher zugeschnitten oder neu beleuchtet werden.

  2. 2

    2. Schreibe die Figur

    Größe, Statur, Haarlänge, eine kräftige Outfitfarbe, ein Attitüden-Hinweis. Beispiel: „eine große Tänzerin in einer kurzen roten Jacke und schwarzer weiter Hose, Kinn hoch, deadpan.“ Halte die Person erfunden – nur fiktive Figuren.

  3. 3

    3. Schreibe Szene und Kamera

    Nenne Ort, Licht und Framing: „leerer U-Bahnsteig, hartes Deckenlicht, langsamer Push-in, vertikal 9:16.“ Sag, wo der Point landet – in der ersten Sekunde oder auf halber Strecke –, damit die Geste nicht untergeht.

  4. 4

    4. Rendere und prüfe

    Rendere einen Standard-Clip in 720p mit 12 Sekunden für 35 Credits; Credits starten bei $9.90. Wenn das Rendering fehlschlägt, gehen die Credits zurück auf dein Guthaben, und du kannst den Prompt schärfen und es erneut versuchen.

Mit einem getesteten Prompt starten

Jeder Prompt ist vollständig: Motiv, Szene, Kamera und was sich nicht ändern darf. Kopiere ihn oder öffne das Studio damit.

Eine beschriebene Figur in einer kurzen roten Jacke mitten im Finger-Gun-Point in einem neonbeleuchteten Korridor, gerendert als 9:16-Tanzclip

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Im Studio verwenden

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Im Studio verwenden

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (Englisch)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Im Studio verwenden

Wie Text-to-Dance einen Clip rendert

Text-to-Dance überspringt den Bild-Upload. Dein Prompt wird als drei Slots gelesen – Subjekt, Setting, Aktion – und das Modell baut eine konsistente Figur über die vollen 12 Sekunden, statt in jedem Frame ein Gesicht neu zu raten. Darum zählt die Qualität der Beschreibung hier mehr als im Foto-Modus: Nichts wird durch ein Referenzbild festgelegt.

Ein Standard-Rendering ist 720p, vertikal 9:16, 12 Sekunden – die Form eines Reels- oder TikTok-Uploads. Längere oder schärfere Ausgaben kosten mehr Credits. Ein fehlgeschlagenes Rendering wird erstattet, ein schlechter Take frisst also nicht still dein Guthaben.

Was in eine Figurenbeschreibung gehört

Führe mit Silhouette, nicht mit Detail. Größe, Statur, Haarlänge und eine kräftige Outfitfarbe sind bei 720p sofort lesbar; sechs Accessoires verschwimmen bei dieser Größe zu Rauschen.

Gib dann eine Haltung an, aus der die Choreografie herausschnappen kann – Kinn hoch, Schultern locker, deadpan. Der Hero-Point ist eine kurze, scharfe Geste, also braucht das Modell eine Ausgangshaltung, keinen Persönlichkeitsaufsatz.

Halte die Figur fiktiv. Beschreibe erfundene Personen; frag nicht nach einem realen Performer, einem IVE-Mitglied oder der Ähnlichkeit einer Person.

Credits, Preise und was ein Clip wirklich kostet

Credits starten bei $9.90. Ein Standard-Clip in 720p mit 12 Sekunden kostet 35 Credits, ein bescheidenes Top-up kauft also einen ersten Versuch und einen Reshoot, ohne ein Abo abzuschließen, dessen Kündigung du vergisst.

Fehlgeschlagene Renderings werden deinem Guthaben erstattet, du zahlst also für gelieferte Clips statt für Wartezeit. In der ganzen Pipeline werden keine offizielle Aufnahme, kein Musikvideo-Material und keine Ähnlichkeiten von Mitgliedern verwendet – das Ergebnis ist eine beschriebene, erfundene Figur.

Häufige Fragen

Brauche ich ein Foto, um einen Text-to-Dance-Clip zu erstellen?

Nein. Der Text-to-Dance-Modus nimmt eine geschriebene Figurenbeschreibung und eine Szene statt eines Uploads. Der Foto-Modus existiert weiterhin, falls du lieber mit einem Selfie startest – diese Seite behandelt den Weg ohne Foto.

Was kostet ein Clip?

Credits starten bei $9.90. Ein Standard-Clip in 720p mit 12 Sekunden kostet 35 Credits. Fehlgeschlagene Renderings werden deinem Guthaben erstattet, ein Fehler kostet dich also keine Credits.

Ist der offizielle „Looks Can Kill“-Sound enthalten?

Nein. Es werden keine offizielle Aufnahme, kein Musikvideo-Material und keine Ähnlichkeiten von Mitgliedern verwendet. Clips sind stumm oder tragen das Audio, das du später in deinem eigenen Editor hinzufügst.

Kann ich eine reale Person beschreiben, zum Beispiel ein IVE-Mitglied?

Nein. Text-to-Dance ist für fiktive Figuren gedacht. Prompts, die reale Performer nennen oder die Ähnlichkeit eines bestimmten Idols verlangen, werden nicht unterstützt; der Trend, auf den diese Seite reagiert, ist Fan-made und nicht mit IVE oder Starship verbunden.

Wie lang und wie scharf ist die Ausgabe?

Standard-Renderings sind 12 Sekunden bei 720p im vertikalen 9:16-Format – genug für einen vollständigen Hero-Point-Durchlauf mit einem Beat Lead-in. Längere oder höher aufgelöste Renderings kosten mehr Credits.

Ist Looks Can Kill AI offiziell?

Nein. Es ist ein unabhängiges Studio, nicht mit IVE oder Starship Entertainment verbunden. „Looks Can Kill“ ist IVEs Titeltrack von ihrer fünften EP, mit der Single am 19. Oktober 2026 und der EP am 26. Oktober 2026; dieses Tool reagiert nur auf den Fan-made Tanz-Trend darum herum.

Mach aus deinem Foto einen Clip

Starte mit der Vorlage auf dieser Seite oder schreibe deine eigene Aufnahme. Die Credits werden vor dem Rendern angezeigt; fehlgeschlagene Renderings werden erstattet.