テキスト・トゥ・ダンスモード · 写真不要

Text to Dance Video:キャラクターを描写してダンスクリップをレンダー

テキスト・トゥ・ダンスモードは、いつものワークフローを逆転させます。写真をアップロードしてモデルが顔を保ってくれることを願う代わりに、キャラクターの描写——年齢層、体格、髪、衣装、態度——と、その人物の周囲に欲しいシーンを入力します。レンダーはその描写を、Looks Can Killの振り付けからヒーローポイントを決める人物の短い縦型クリップに変えます。自撮りも、写真のクリーンアップ工程も、どのアップロードがレンダーに耐えるかを推測する必要もありません。

トレンド自体はファンメイドです。IVEが5枚目のEPのタイトル曲として「Looks Can Kill」をリリースしたとき——シングルは2026年10月19日、EPは2026年10月26日——ガールヒーローのコンセプトとフィンガーガンの指差しが、人々に一発撮りで自分を撮影させるきっかけになりました。テキスト・トゥ・ダンスはそのクリップの形を保ちつつ、元の写真を不要にします。存在しない人物を創造し、本来なら撮影できないシーンに置くのです。

このページのクリップはAIが生成したプレビューです。架空のものであり、実際の出来事の記録ではありません。

2026年10月20日更新

書かれたキャラクター描写からテキスト・トゥ・ダンスモードで生成された縦型ダンスクリップ
長さ
5〜12秒
解像度
480p · 720p · 1080p
アスペクト比
9:16 · 16:9 · 1:1
ウォーターマーク
有料レンダーはなし
モデル
Seedance 2.0
モデレーション
SeeAPI、失敗時はブロック

写真なし、顔のドリフトなし

写真モードでは、モデルがアップロードされた顔をフレーム間で一貫して保つ必要があります。テキスト・トゥ・ダンスは代わりに描写から人物を構築するため、ドリフトする顔はありません——ただし、シルエットから衣装の色まで、見た目のすべてを描写が担う必要があります。

ヒーローポイント向けのフレーミング

デフォルトの出力は9:16の縦型・12秒で、「Looks Can Kill」の振り付けにあるフィンガーガンの指差しに適しています。導入の1拍、鋭いジェスチャー1つ、短い余韻。クリップのどこで指差しが決まるかも指定できます。

クレジットはわかりやすく価格設定

クレジットは$9.90から。標準の720p・12秒クリップは35クレジットなので、少額のチャージで数テイク分をまかなえます。失敗したレンダーは返金され、納品されなかったクリップに課金されることはありません。

使い方

  1. 1

    テキスト・トゥ・ダンスに切り替える

    スタジオを開き、写真アップロードではなくテキスト・トゥ・ダンスタブを選びます。プロンプト欄は「キャラクター」と「シーン」の2つ。何もアップロードしないので、先にトリミングやライティング調整をする必要はありません。

  2. 2

    キャラクターを書く

    身長、体格、髪の長さ、印象的な衣装の色を1つ、態度の手がかりを1つ。例:「背の高いダンサー。クロップド丈の赤いジャケットと黒のワイドパンツ、あごを上げ、無表情」。人物は創作に限定し、架空のキャラクターだけにしてください。

  3. 3

    シーンとカメラを書く

    場所、光、フレーミングを指定します:「誰もいない地下鉄のホーム、硬い頭上照明、ゆっくりしたプッシュイン、縦型9:16」。指差しがどこで決まるか——冒頭の1秒か中盤か——を伝えて、ジェスチャーが埋もれないようにしましょう。

  4. 4

    レンダーして確認

    標準の720p・12秒クリップを35クレジットでレンダーします。クレジットは$9.90から。レンダーが失敗するとクレジットは残高に戻るので、プロンプトを調整して再試行できます。

検証済みのプロンプトから始める

各プロンプトは被写体・シーン・カメラ・変えてはいけない点まで含まれています。コピーするか、スタジオに読み込んで使えます。

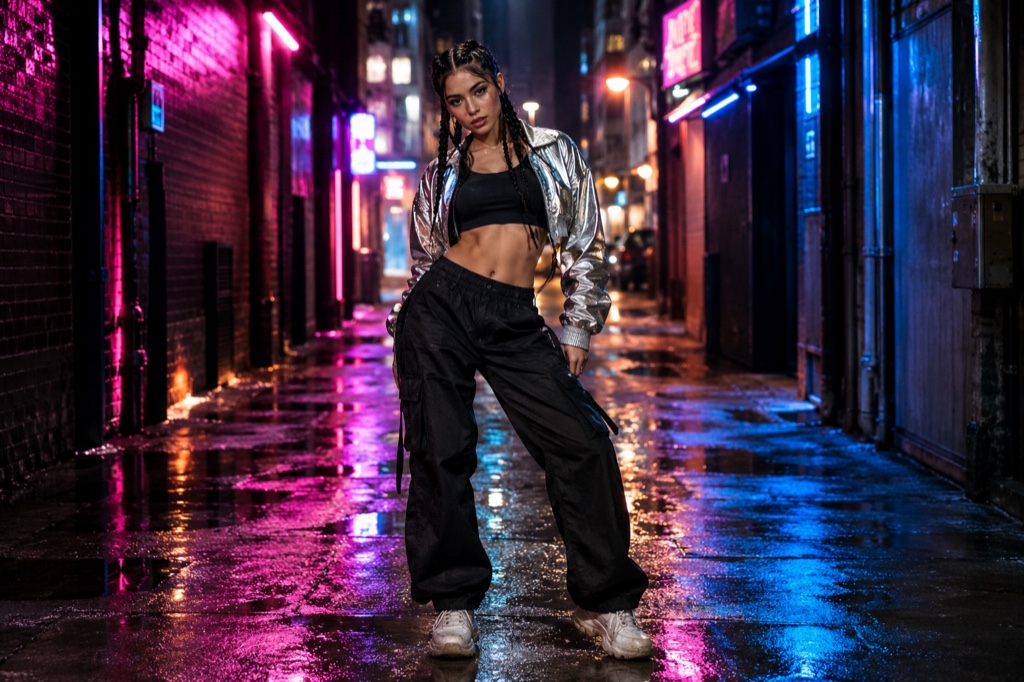
ネオンに照らされた廊下で、クロップド丈の赤いジャケットを着た描写済みキャラクターがフィンガーガンの指差しの途中にいる様子を、9:16のダンスクリップとしてレンダーしたもの

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

プロンプト(英語)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

スタジオで使う

Comic frame

A comic frame scene with a tighter camera and a held final pose.

プロンプト(英語)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

スタジオで使う

Practice room

A practice room scene for a more graphic, stylised result.

プロンプト(英語)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

スタジオで使う

テキスト・トゥ・ダンスがクリップをレンダーする仕組み

テキスト・トゥ・ダンスは画像アップロード段階を省きます。プロンプトは「被写体」「設定」「動作」の3つの枠として読まれ、モデルはフレームごとに顔を推測し直すのではなく、12秒全体にわたって一貫した人物を構築します。だからこそ写真モードより描写の質が重要です。参照画像によって固定されるものが何もないからです。

標準レンダーは720p、9:16の縦型、12秒——ReelsやTikTokへの投稿に合う形です。長尺または高精細な出力はより多くのクレジットが必要です。失敗したレンダーは返金されるので、悪いテイクが知らないうちに残高を削ることはありません。

キャラクター描写に入れるべきもの

細部ではなくシルエットから始めましょう。身長、体格、髪の長さ、印象的な衣装の色1つは720pでも即座に伝わりますが、6つのアクセサリーはそのサイズではノイズに溶けます。

次に、振り付けがそこからキレよく飛び出せる姿勢を1つ——あごを上げ、肩の力を抜き、無表情。ヒーローポイントは短く鋭いジェスチャーなので、モデルに必要なのは性格の作文ではなく、破るべき構えです。

キャラクターは架空に保ちましょう。創作した人物を描写し、実在のパフォーマー、IVEのメンバー、誰かの肖像を求めてはいけません。

クレジット、価格、クリップの実際のコスト

クレジットは$9.90から。標準の720p・12秒クリップは35クレジットなので、控えめなチャージで最初の試作と撮り直し分を買えます。解約を忘れそうなサブスクに縛られる必要はありません。

失敗したレンダーは残高に返金されるため、待ち時間ではなく納品されたクリップに支払うことになります。パイプラインのどこでも公式音源、ミュージックビデオ映像、メンバーの肖像は使用されません——出力は、描写された架空のキャラクターです。

よくある質問

テキスト・トゥ・ダンスのクリップを作るのに写真は必要ですか?

いいえ。テキスト・トゥ・ダンスモードでは、アップロードの代わりに書かれたキャラクター描写とシーンを使います。自撮りから始めたい場合のために写真モードも残っていますが、このページでは写真なしの方法を扱います。

クリップの費用はいくらですか?

クレジットは$9.90から。標準の720p、12秒の縦型クリップは35クレジットです。失敗したレンダーは残高に返金されるため、エラーでクレジットを失うことはありません。

公式の「Looks Can Kill」音源は含まれますか?

いいえ。公式音源、ミュージックビデオ映像、メンバーの肖像は使用されません。クリップは無音か、後からご自身のエディターで追加した音声が入ります。

IVEのメンバーのような実在の人物を描写できますか?

いいえ。テキスト・トゥ・ダンスは架空のキャラクター向けです。実在のパフォーマーを名指ししたり、特定のアイドルの肖像を求めるプロンプトはサポートされません。このサイトが応えるトレンドはファンメイドで、無関係なものです。

出力の長さと解像度はどれくらいですか?

標準レンダーは12秒、720p、9:16の縦型フレーム——導入の1拍を含むヒーローポイント1回分に十分です。長尺または高解像度のレンダーはより多くのクレジットが必要です。

Looks Can Kill AIは公式ですか?

いいえ。独立したスタジオで、IVEやStarship Entertainmentとは無関係です。「Looks Can Kill」はIVEの5枚目のEPのタイトル曲で、シングルは2026年10月19日、EPは2026年10月26日。このツールは、それをめぐるファンメイドのダンストレンドに応えるだけのものです。

写真をクリップに変える

このページのプリセットから始めるか、自分のカットを書いてください。生成前にクレジットが表示され、失敗したレンダーは返金されます。