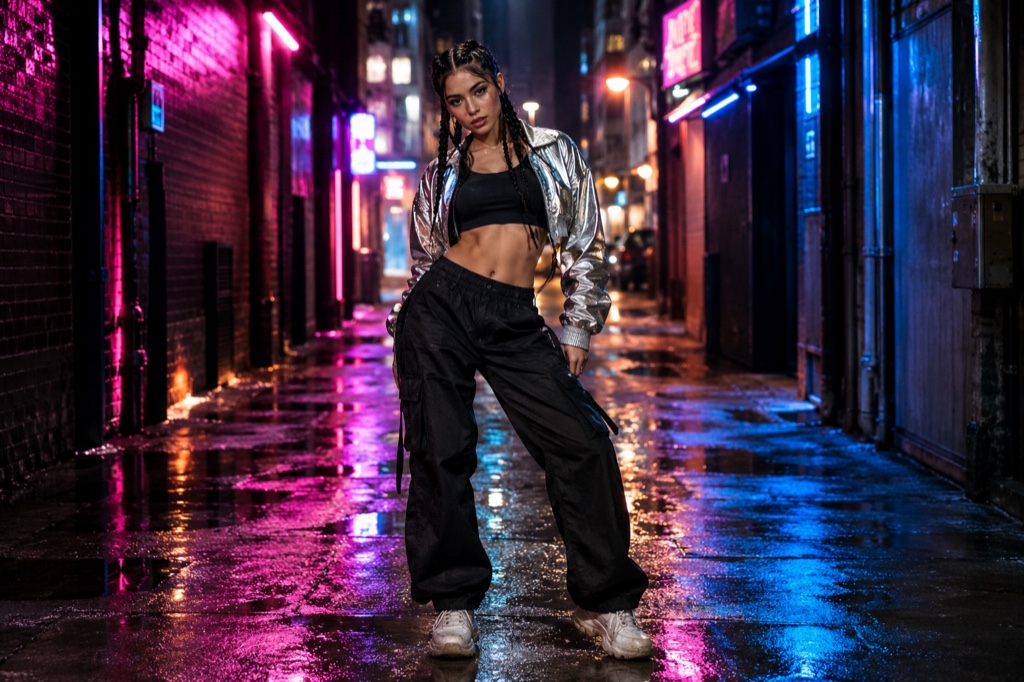
텍스트 투 댄스 모드 · 사진 불필요

텍스트 투 댄스 영상: 캐릭터를 설명하고 댄스 클립 렌더하기

텍스트 투 댄스 모드는 일반적인 작업 흐름을 뒤집습니다. 사진을 업로드하고 모델이 얼굴을 유지해 주길 바라는 대신, 캐릭터 설명(연령대, 체형, 머리, 의상, 태도)과 원하는 장면을 직접 입력합니다. 렌더는 그 설명을, 'Looks Can Kill' 안무의 히어로 포인트를 취하는 인물이 담긴 짧은 세로 클립으로 바꿔 줍니다. 셀피도, 사진 보정 단계도, 어떤 업로드가 렌더를 통과할지 추측할 필요도 없습니다.

이 트렌드 자체는 팬들이 만든 것입니다. IVE가 다섯 번째 EP의 타이틀곡 'Looks Can Kill'을 공개했을 때 — 싱글은 2026년 10월 19일, EP는 2026년 10월 26일 — 걸 히어로 콘셉트와 핑거건 포인트 덕에 사람들은 원 테이크로 자신을 촬영했습니다. 텍스트 투 댄스는 그 클립의 형태는 유지하되 원본 사진을 없앱니다. 존재하지 않는 인물을 만들어, 실제로는 촬영할 수 없을 장면에 배치하는 것이죠.

이 페이지의 클립은 AI가 생성한 미리보기입니다. 허구이며 실제 사건의 기록이 아닙니다.

2026년 10월 20일 업데이트

작성한 캐릭터 설명으로 텍스트 투 댄스 모드에서 생성한 세로 댄스 클립
길이
5–12초
해상도
480p · 720p · 1080p
화면 비율
9:16 · 16:9 · 1:1
워터마크
유료 렌더는 없음
모델
Seedance 2.0
검열
SeeAPI, 실패 시 차단

사진 없음, 얼굴 흐트러짐 없음

사진 모드에서는 모델이 업로드된 얼굴을 프레임마다 일관되게 유지해야 합니다. 텍스트 투 댄스는 대신 설명으로 인물을 구성하므로 흐트러질 얼굴이 없습니다. 다만 실루엣부터 의상 색까지 전체 룩을 설명이 담아내야 합니다.

히어로 포인트에 맞춘 프레이밍

기본 출력은 9:16 세로, 12초로 'Looks Can Kill' 안무의 핑거건 포인트에 잘 맞습니다. 도입 한 박자, 날카로운 제스처 하나, 짧은 마무리로 구성되죠. 클립 어디에서 포인트가 나올지 지정할 수 있습니다.

크레딧, 간단한 가격

크레딧은 $9.90부터 시작합니다. 표준 720p 12초 클립은 35 크레딧이므로 소액 충전으로 두어 번의 테이크를 커버할 수 있습니다. 실패한 렌더는 환불되며, 결과물이 나오지 않은 클립에는 비용이 청구되지 않습니다.

사용 방법

  1. 1

    텍스트 투 댄스로 전환

    스튜디오를 열고 사진 업로드 대신 텍스트 투 댄스 탭을 선택하세요. 캐릭터와 장면, 두 개의 프롬프트 필드가 제공됩니다. 업로드하는 것이 없으니 먼저 자르거나 조명을 다시 맞출 필요도 없습니다.

  2. 2

    캐릭터 쓰기

    키, 체형, 머리 길이, 강조할 의상 색 하나, 태도 힌트 하나. 예: '크롭된 빨간 재킷과 검은 와이드 팬츠를 입은 키 큰 댄서, 턱을 들고 무표정.' 인물은 반드시 지어낸 사람이어야 합니다. 가상 캐릭터만 사용하세요.

  3. 3

    장면과 카메라 쓰기

    장소, 조명, 프레이밍을 지정하세요. '텅 빈 지하철 승강장, 강한 머리 위 조명, 느린 푸시인, 세로 9:16.' 포인트가 언제 나오는지(오프닝 1초 또는 중반) 말해 제스처가 묻히지 않게 하세요.

  4. 4

    렌더하고 확인

    표준 720p 12초 클립을 35 크레딧으로 렌더하세요. 크레딧은 $9.90부터 시작합니다. 렌더가 실패하면 크레딧이 잔액으로 돌아오며, 프롬프트를 다듬어 다시 시도할 수 있습니다.

검증된 프롬프트로 시작

각 프롬프트는 피사체, 장면, 카메라, 바뀌면 안 되는 요소까지 포함합니다. 복사하거나 스튜디오에 불러오세요.

네온 조명이 비치는 복도에서 크롭된 빨간 재킷을 입은 묘사 속 캐릭터가 핑거건 포인트를 취하는 순간을 9:16 댄스 클립으로 렌더한 이미지

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

프롬프트(영어)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

스튜디오에서 사용

Comic frame

A comic frame scene with a tighter camera and a held final pose.

프롬프트(영어)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

스튜디오에서 사용

Practice room

A practice room scene for a more graphic, stylised result.

프롬프트(영어)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

스튜디오에서 사용

텍스트 투 댄스가 클립을 렌더하는 방식

텍스트 투 댄스는 이미지 업로드 단계를 건너뜁니다. 프롬프트는 주체, 배경, 동작의 세 가지 슬롯으로 읽히며, 모델은 프레임마다 얼굴을 다시 추측하는 대신 12초 전체에 걸쳐 일관된 인물 하나를 구성합니다. 그래서 사진 모드보다 설명의 품질이 더 중요합니다. 참조 이미지로 고정해 주는 것이 없기 때문입니다.

표준 렌더는 720p, 9:16 세로, 12초로 Reels나 TikTok 업로드에 맞는 형태입니다. 더 길거나 더 선명한 출력은 크레딧이 더 듭니다. 실패한 렌더는 환불되므로 잘못된 테이크가 조용히 잔액을 갉아먹지 않습니다.

캐릭터 설명에 들어가야 할 것

디테일보다 실루엣을 먼저 쓰세요. 키, 체형, 머리 길이, 강조할 의상 색 하나는 720p에서 즉시 읽히지만, 액세서리 여섯 개는 그 크기에서 노이즈처럼 흐려집니다.

그다음 안무가 시작될 수 있는 자세 하나를 주세요. 턱을 들고, 어깨는 힘을 빼고, 무표정. 히어로 포인트는 짧고 날카로운 제스처라서 모델에는 성격 에세이가 아니라 깨고 나올 자세가 필요합니다.

캐릭터는 가상으로 유지하세요. 지어낸 인물을 설명하고, 실제 연예인, IVE 멤버, 누군가의 초상을 요청하지 마세요.

크레딧, 가격, 클립의 실제 비용

크레딧은 $9.90부터 시작합니다. 표준 720p 12초 클립은 35 크레딧이므로, 적당히 충전하면 해지하는 걸 잊을 구독에 묶이지 않고 첫 시도와 재촬영을 해볼 수 있습니다.

실패한 렌더는 잔액으로 환불되므로 대기 시간이 아니라 결과물이 나온 클립에 비용을 지불합니다. 파이프라인 어디에도 공식 음원, 뮤직비디오 영상, 멤버의 초상은 사용되지 않습니다. 출력물은 설명으로 만든 가상 캐릭터입니다.

자주 묻는 질문

텍스트 투 댄스 클립을 만들려면 사진이 필요한가요?

아니요. 텍스트 투 댄스 모드는 업로드 대신 작성한 캐릭터 설명과 장면을 받습니다. 셀피에서 시작하고 싶다면 사진 모드도 여전히 있지만, 이 페이지는 사진 없는 방법을 다룹니다.

클립 비용은 얼마인가요?

크레딧은 $9.90부터 시작합니다. 표준 720p, 12초 세로 클립은 35 크레딧입니다. 실패한 렌더는 잔액으로 환불되므로 오류로 크레딧을 잃지 않습니다.

공식 'Looks Can Kill' 오디오가 포함되나요?

아니요. 공식 음원, 뮤직비디오 영상, 멤버의 초상은 사용되지 않습니다. 클립은 무음이거나, 이후 본인 편집기에서 추가한 오디오만 담습니다.

IVE 멤버처럼 실제 인물을 설명할 수 있나요?

아니요. 텍스트 투 댄스는 가상 캐릭터용입니다. 실제 연예인의 이름을 쓰거나 특정 아이돌의 초상을 요청하는 프롬프트는 지원되지 않습니다. 이 사이트가 다루는 트렌드는 팬메이드이며 공식과 무관합니다.

출력물은 얼마나 길고 얼마나 선명한가요?

표준 렌더는 9:16 세로 프레임의 720p 12초로, 도입 한 박자를 포함한 히어로 포인트 동작 한 번을 담기에 충분합니다. 더 길거나 더 높은 해상도의 렌더는 크레딧이 더 듭니다.

Looks Can Kill AI는 공식인가요?

아니요. 독립 스튜디오이며 IVE 또는 Starship Entertainment와 무관합니다. 'Looks Can Kill'은 IVE의 다섯 번째 EP 타이틀곡으로, 싱글은 2026년 10월 19일, EP는 2026년 10월 26일 공개되었습니다. 이 도구는 해당 곡을 둘러싼 팬메이드 댄스 트렌드에만 대응합니다.

사진을 클립으로 바꾸세요

이 페이지의 프리셋으로 시작하거나 직접 장면을 쓰세요. 생성 전에 크레딧이 표시되고 실패한 렌더는 환불됩니다.