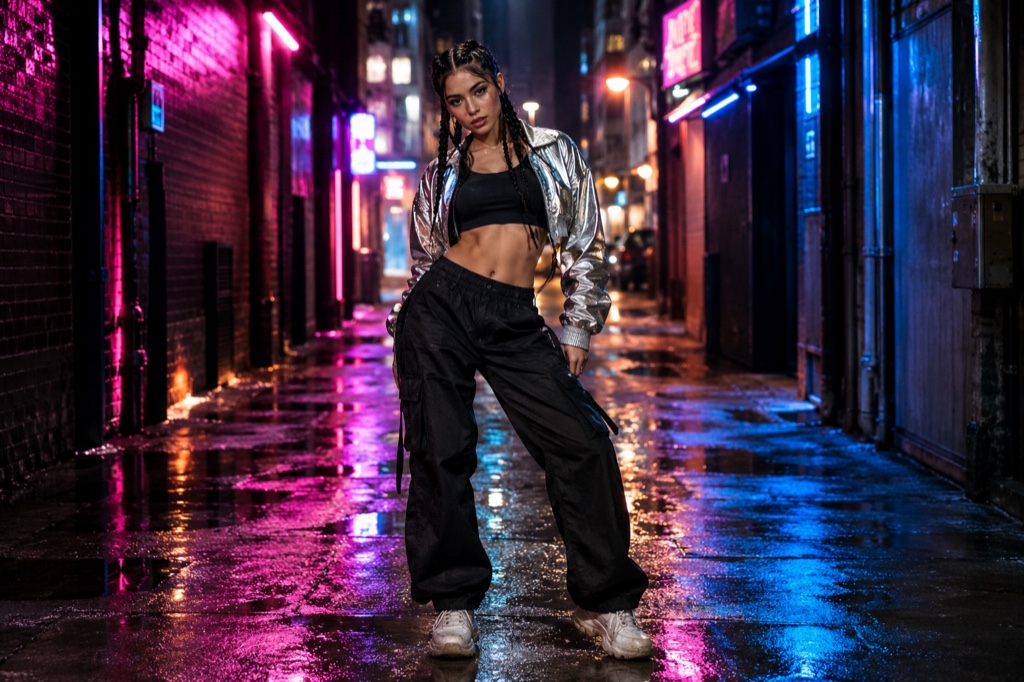
Modo texto para dança · sem foto

Vídeo de dança a partir de texto: descreva um personagem e renderize um clipe de dança

O modo texto para dança inverte o fluxo habitual. Em vez de enviar uma foto e torcer para o modelo manter o rosto, você digita a descrição de um personagem — faixa etária, porte físico, cabelo, roupa, atitude — além da cena que quer ao redor dele. A renderização transforma essa descrição em um clipe vertical curto de uma figura executando a pose de heroína da coreografia de Looks Can Kill. Sem selfie, sem etapa de tratamento de foto e sem adivinhar qual upload sobrevive à renderização.

A tendência em si é feita por fãs. Quando a IVE lançou “Looks Can Kill” como faixa-título do quinto EP — single em 19 de outubro de 2026 e EP em 26 de outubro de 2026 —, o conceito girl hero e o gesto de arma com os dedos fizeram as pessoas se filmarem em uma única tomada. O texto para dança mantém o formato desse clipe, mas dispensa a foto de origem: você inventa alguém que não existe e coloca essa pessoa em uma cena que nunca conseguiria filmar.

Os clipes desta página são prévias geradas por IA. São fictícios e não documentam um evento real.

Atualizado em 20 de outubro de 2026

Clipe de dança vertical gerado no modo texto para dança a partir de uma descrição escrita de personagem
Duração
5–12 segundos
Resolução
480p · 720p · 1080p
Proporção
9:16 · 16:9 · 1:1
Marca d’água
Nenhuma nos renderes pagos
Modelo
Seedance 2.0
Moderação
SeeAPI, fail-closed

Sem foto, sem desvio de rosto

No modo foto, o modelo precisa manter um rosto enviado consistente entre os frames. O texto para dança constrói a figura a partir da descrição, então não há rosto para desviar — mas a descrição precisa carregar o visual inteiro, da silhueta à cor da roupa.

Enquadrado para a pose de heroína

O resultado padrão é vertical em 9:16 e tem 12 segundos, o que combina com o gesto de arma com os dedos na coreografia de “Looks Can Kill”: uma batida de introdução, um gesto seco e um final curto. Você pode indicar em que momento do clipe o gesto de apontar acontece.

Créditos com preço claro

Os créditos começam em $9.90. Um clipe padrão em 720p de 12 segundos custa 35 créditos, então uma recarga pequena cobre algumas tentativas. Renderizações com falha são reembolsadas — você não paga por um clipe que não foi entregue.

Como funciona

  1. 1

    Mude para texto para dança

    Abra o estúdio e escolha a aba texto para dança em vez do upload de foto. Você tem dois campos de prompt: personagem e cena. Nada é enviado, então nada precisa ser recortado ou ter a iluminação ajustada antes.

  2. 2

    Descreva o personagem

    Altura, porte físico, comprimento do cabelo, uma cor forte de roupa e uma pista de atitude. Exemplo: “uma dançarina alta com jaqueta vermelha curta e calça preta de pernas largas, queixo erguido, expressão séria”. Mantenha a pessoa inventada — apenas personagens fictícios.

  3. 3

    Descreva a cena e a câmera

    Indique o local, a luz e o enquadramento: “plataforma de metrô vazia, luz dura vinda de cima, movimento lento de aproximação, vertical em 9:16”. Diga onde o gesto de apontar acontece — no primeiro segundo ou na metade — para ele não se perder.

  4. 4

    Renderize e confira

    Renderize um clipe padrão em 720p de 12 segundos por 35 créditos; os créditos começam em $9.90. Se a renderização falhar, os créditos voltam para o seu saldo, e você pode refinar o prompt e tentar de novo.

Comece com um prompt testado

Cada prompt é completo: assunto, cena, câmera e o que não pode mudar. Copie ou abra o estúdio já preenchido.

Personagem descrito com jaqueta vermelha curta no meio de um gesto de arma com os dedos em um corredor iluminado por neon, renderizado como clipe de dança em 9:16

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (inglês)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usar no estúdio

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (inglês)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usar no estúdio

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (inglês)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usar no estúdio

Como o texto para dança renderiza um clipe

O texto para dança pula a etapa de upload de imagem. Seu prompt é lido em três partes — assunto, cenário e ação —, e o modelo constrói uma figura consistente ao longo dos 12 segundos inteiros em vez de adivinhar um rosto a cada frame. É por isso que a qualidade da descrição importa mais aqui do que no modo foto: nada é fixado por uma imagem de referência.

Uma renderização padrão é em 720p, vertical em 9:16 e tem 12 segundos — o formato de um upload para Reels ou TikTok. Resultados mais longos ou mais nítidos custam mais créditos. Uma renderização com falha é reembolsada, então uma tentativa ruim não corrói seu saldo sem aviso.

O que deve entrar na descrição de um personagem

Comece pela silhueta, não pelo detalhe. Altura, porte físico, comprimento do cabelo e uma cor forte de roupa são lidos na hora em 720p; seis acessórios viram ruído naquele tamanho.

Depois, dê uma postura da qual a coreografia possa partir — queixo erguido, ombros soltos, expressão séria. A pose de heroína é um gesto curto e seco, então o modelo precisa de uma base para romper, não de uma redação sobre personalidade.

Mantenha o personagem fictício. Descreva pessoas inventadas; não peça por um artista real, uma integrante da IVE ou a imagem de qualquer pessoa.

Créditos, preços e quanto um clipe custa de verdade

Os créditos começam em $9.90. Um clipe padrão em 720p de 12 segundos custa 35 créditos, então uma recarga modesta compra uma primeira tentativa e uma regravação sem compromisso com uma assinatura que você vai esquecer de cancelar.

Renderizações com falha são reembolsadas no seu saldo, então você paga pelos clipes entregues, não pelo tempo na fila. Nenhuma gravação oficial, imagem de videoclipe ou semelhança de integrante é usada em qualquer etapa do processo — o resultado é um personagem inventado e descrito.

Perguntas frequentes

Preciso de uma foto para criar um clipe no modo texto para dança?

Não. O modo texto para dança usa uma descrição escrita de personagem e uma cena em vez de um upload. O modo foto continua disponível se você preferir começar com uma selfie — esta página cobre o caminho sem foto.

Quanto custa um clipe?

Os créditos começam em $9.90. Um clipe vertical padrão em 720p de 12 segundos custa 35 créditos. Renderizações com falha são reembolsadas no seu saldo, então um erro não custa créditos.

O áudio oficial de “Looks Can Kill” está incluído?

Não. Nenhuma gravação oficial, imagem de videoclipe ou semelhança de integrante é usada. Os clipes são silenciosos ou trazem o áudio que você adicionar depois no seu próprio editor.

Posso descrever uma pessoa real, como uma integrante da IVE?

Não. O texto para dança é para personagens fictícios. Prompts que nomeiam artistas reais ou pedem a imagem de um ídolo específico não são suportados; a tendência à qual este site responde é feita por fãs e não é afiliada.

Qual é a duração e a nitidez do resultado?

As renderizações padrão têm 12 segundos em 720p, em um frame vertical 9:16 — o suficiente para uma passagem completa da pose de heroína com uma batida de introdução. Renderizações mais longas ou em resolução maior custam mais créditos.

O Looks Can Kill AI é oficial?

Não. É um estúdio independente, sem vínculo com IVE ou Starship Entertainment. “Looks Can Kill” é a faixa-título da IVE em seu quinto EP, com o single em 19 de outubro de 2026 e o EP em 26 de outubro de 2026; esta ferramenta apenas responde à tendência de dança feita por fãs em torno disso.

Transforme sua foto em um clipe

Comece com o preset desta página ou escreva seu próprio plano. Os créditos aparecem antes de gerar e renderes com falha são reembolsados.