Hecho por fans · independiente · no afiliado a IVE ni a Starship

IA de baile K-pop: el lenguaje visual de la coreografía de punto K-pop, traducido a una sola foto

La coreografía de punto K-pop está hecha para la segunda cámara. Un bloqueo de hombros, un giro de muñeca, una pistola con los dedos apuntando directo al objetivo: el movimiento que un fancam repite en bucle durante tres semanas. «Looks Can Kill» de IVE se apoya con fuerza en esa lógica con su concepto girl hero, y la tendencia de fans en torno a ella es aún más simple: entra una foto, sale un clip vertical corto de ti haciendo el hero point. Nada de rutina que memorizar, nada de grupo con el que sincronizarse.

Lo que sigue es un desglose de esa gramática visual —líneas enmarcadas, timing de golpe y pausa, la silueta heroica— y de cómo un flujo de trabajo de una sola foto la reproduce sin un estudio de baile. Subes una imagen, describes el movimiento del hero point en texto y el estudio renderiza un clip vertical de 12 segundos en 720p por 35 créditos. Los créditos comienzan en $9.90, los renders fallidos se reembolsan y nada de esto utiliza la grabación oficial ni la imagen de las integrantes.

Los clips de esta página son vistas previas generadas por IA. Son ficticios y no documentan un evento real.

Actualizado el 20 de octubre de 2026

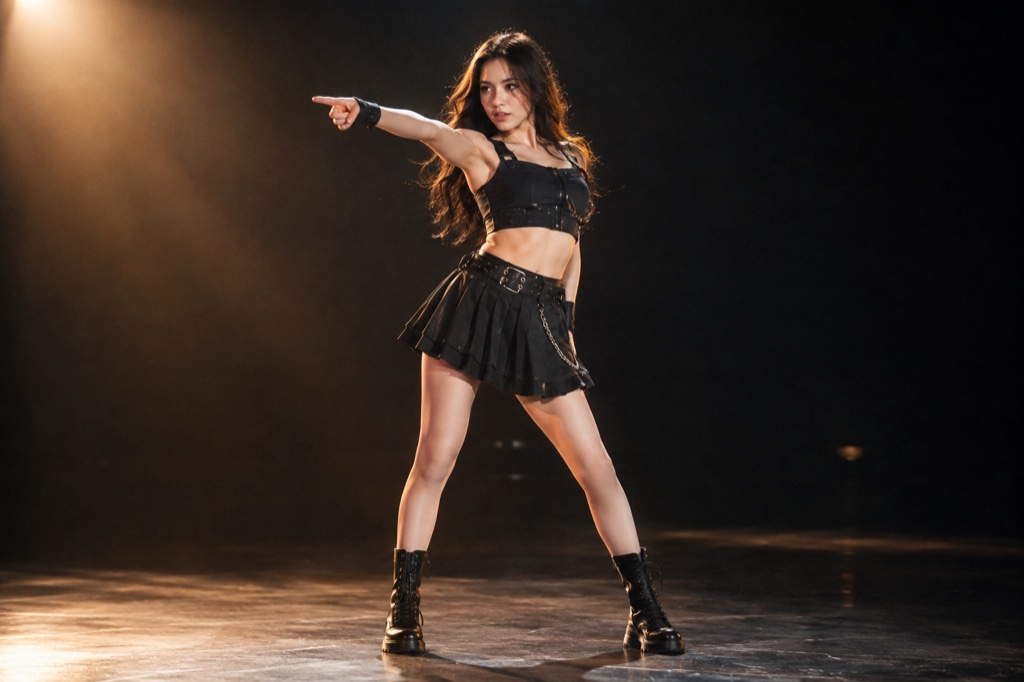
Fotograma vertical 9:16 de un bailarín en pleno hero point, con un brazo extendido hacia la cámara en un gesto de pistola con los dedos, iluminado frontalmente contra un escenario oscuro
Duración
5–12 segundos
Resolución
480p · 720p · 1080p
Relación de aspecto
9:16 · 16:9 · 1:1
Marca de agua
Ninguna en los renders de pago
Modelo
Seedance 2.0
Moderación
SeeAPI, fail-closed

El movimiento de punto es la unidad, no la rutina

Este estudio no intenta reconstruir una secuencia completa de treinta segundos. Se centra en el gesto que sostiene la canción —para «Looks Can Kill», el hero point con pistola de dedos— y lo mantiene el tiempo suficiente para que se lea en una pantalla de móvil sostenida a la distancia de un brazo.

Una imagen, sin video de referencia

No subes metraje tuyo bailando ni igualas el fancam de una integrante fotograma a fotograma. Una sola foto clara, más una breve descripción de texto del movimiento, es toda la entrada. La foto aporta cuerpo, vestuario e iluminación; el texto aporta el movimiento.

Precio por clip, reembolso si falla

Un clip vertical estándar de 12 segundos en 720p cuesta 35 créditos, y los créditos comienzan en $9.90. Si un render falla, esos créditos vuelven a tu saldo: pagas por resultados utilizables, no por intentos.

Cómo funciona

  1. 1

    Sube una foto

    Elige una toma nítida de cuerpo entero o de tres cuartos con las manos visibles y sin recortar. Una iluminación frontal uniforme y un fondo liso le dan al modelo una silueta más limpia que animar que una escena recargada o un selfi en contrapicado.

  2. 2

    Describe el hero point

    Escribe el gesto como lo indicaría un coreógrafo: qué brazo dispara hacia el objetivo, dónde chasquea la muñeca, si el pecho está elevado y la barbilla baja, cuánto rotan los hombros en el golpe. Dos o tres líneas concretas superan a un párrafo de palabras de ambiente.

  3. 3

    Renderiza el clip de 12 segundos

    El estudio produce un video vertical en 9:16 de 720p —el recorte nativo para la tendencia— por 35 créditos por render estándar. Sin edición de línea de tiempo, sin fotogramas clave, sin una segunda app.

  4. 4

    Revisa y vuelve a renderizar

    Mira primero las manos, las muñecas y la línea del pelo; ahí es donde falla el image-to-video. Si un pase falla directamente, los créditos se reembolsan. Si se renderiza pero el gesto se lee blando, ajusta la descripción y vuelve a ejecutarlo.

Empieza con un prompt probado

Cada prompt es completo: sujeto, escena, cámara y lo que no debe cambiar. Cópialo o abre el estudio con él ya cargado.

Ejemplo lado a lado: un único retrato subido a la izquierda y el clip vertical generado de 12 segundos en 720p a la derecha, capturado en plena coreografía de punto

Spotlight finale

A spotlight finale scene that keeps the face and outfit from your photo.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A dark stage with a single warm spotlight and a thin haze in the air. The person steps into the light, crosses their arms, snaps a finger-gun point at the lens, shifts through a side step, lifts a bent leg and finishes with an arm overhead and a held final pose as the light tightens on them. One continuous vertical 9:16 shot at full-body distance, slow push-in, deep shadows and warm rim light. No text, no watermark, no other people, no real celebrities, no logos.

Usar en el estudio

Practice room

A practice room scene with a tighter camera and a held final pose.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usar en el estudio

Comic frame

A comic frame scene for a more graphic, stylised result.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usar en el estudio

Qué hace que la coreografía de punto K-pop se lea en un móvil

La coreografía de punto es una costumbre de compresión. Un sencillo principal se construye alrededor de dos o tres gestos que sobreviven a un recorte 9:16: una línea limpia del hombro a la punta de los dedos, un golpe que cae en el corte vocal, una silueta que un espectador puede copiar frente al espejo de su habitación. Todo lo demás es tejido conectivo.

«Looks Can Kill» lo lleva a un registro girl hero: barbilla abajo, pecho abierto, pistola de dedos apuntando al objetivo. El gesto es legible en un solo fotograma fijo, y por eso precisamente un flujo de una sola foto puede reproducirlo donde una rutina completa no podría.

Cómo una imagen fija transmite un gesto en movimiento

Tu foto responde a las preguntas estáticas: forma del cuerpo, ropa, pelo, dónde cae la luz, cómo se colocan los hombros. El texto responde a las dinámicas: qué brazo se extiende, con qué rapidez rota la muñeca, si el peso se desplaza al pie delantero en el acento.

Mantener el clip en doce segundos es una restricción deliberada. Los compases cortos y un vertical ajustado mantienen el encuadre en la parte superior del cuerpo, donde viven de verdad los movimientos de punto, y donde es menos probable que aparezcan artefactos en las extremidades.

Límites honestos de la IA de baile K-pop hecha por fans

Esto no es un tutorial de baile, no es un lanzamiento oficial y no está afiliado a IVE ni a Starship Entertainment. No incluye la grabación oficial, el video oficial ni la imagen de ninguna integrante. La salida es un archivo de video silencioso; añade el audio que tengas derecho a usar en otro sitio.

Las rotaciones rápidas de muñeca y los dedos superpuestos siguen siendo la parte frágil de cualquier modelo de image-to-video. Empieza con una foto en la que las manos ya sean visibles y estén bien iluminadas, mantén el gesto lo bastante lento para que se lea y cuenta con un segundo pase antes de que el punto quede limpio.

Preguntas frecuentes

¿Es esta una herramienta oficial de IVE o Starship?

No. Looks Can Kill AI es un estudio independiente hecho por fans. No está afiliado, respaldado ni conectado con IVE o Starship Entertainment, y no utiliza la grabación oficial, el video musical ni la imagen de las integrantes.

¿El clip incluye el audio de «Looks Can Kill»?

No se incluye audio oficial. Recibes un archivo de video vertical en 720p y silencioso, y puedes añadir el sonido que tengas derecho a usar en tu propio editor.

¿Cuánto cuesta realmente un clip?

Los créditos comienzan en $9.90. Un clip vertical estándar de 12 segundos en 720p cuesta 35 créditos, y cualquier render que falle se reembolsa a tu saldo, así que una salida rota nunca te cuesta créditos.

¿Necesito saber ya la coreografía?

No. Describes el gesto en texto plano —dirección del brazo, chasquido de muñeca, hacia dónde miras— y el estudio lo traduce a movimiento. Conocer el punto te ayuda a escribir una descripción más precisa, pero nunca actúas frente a la cámara.

¿Qué foto da el mejor resultado?

Una toma nítida de cuerpo entero o de tres cuartos, con las manos visibles, iluminación frontal uniforme y un fondo que no compita con tu silueta. Evita ángulos extremos, manos recortadas y desenfoque de movimiento intenso; ahí es donde las muñecas y los dedos se rompen primero.

¿Puedo subir una foto de una integrante de IVE o de un amigo?

Sube solo imágenes que tengas derecho a usar, normalmente las tuyas. La imagen de las integrantes no se usa en ninguna parte de este sitio, y generar clips de otras personas sin su permiso no es para lo que está pensado el estudio.

Convierte tu foto en un clip

Empieza con el preset de esta página o escribe tu propio plano. Los créditos se muestran antes de generar y los renders fallidos se reembolsan.