Modo texto a baile · sin foto

Texto a video de baile: describe un personaje y genera un clip de baile

El modo texto a baile le da la vuelta al flujo habitual. En vez de subir una foto y confiar en que el modelo mantenga la cara, escribes una descripción del personaje —rango de edad, complexión, pelo, vestuario, actitud— y la escena que quieres a su alrededor. El render convierte esa descripción en un clip vertical corto de una figura haciendo el hero point de la coreografía de Looks Can Kill. Sin selfie, sin paso de limpieza de foto y sin adivinar qué archivo sobrevive al render.

La tendencia en sí está hecha por fans. Cuando IVE lanzó 'Looks Can Kill' como tema principal de su quinto EP —sencillo el 19 de octubre de 2026, EP el 26 de octubre de 2026—, el concepto girl-hero y el point de finger-gun llevaron a mucha gente a grabarse en una sola toma. El modo texto a baile mantiene la forma de ese clip, pero prescinde de la foto de origen: inventas a alguien que no existe y lo colocas en una escena que nunca podrías rodar.

Los clips de esta página son vistas previas generadas por IA. Son ficticios y no documentan un evento real.

Actualizado el 20 de octubre de 2026

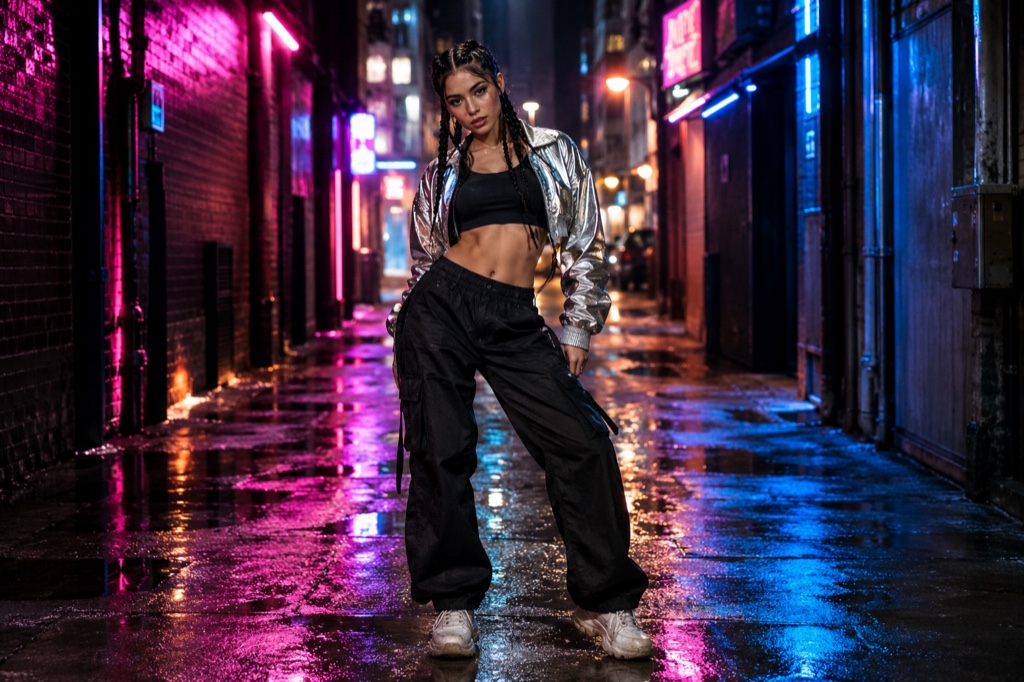
Clip de baile vertical generado en modo texto a baile a partir de una descripción escrita de un personaje
Duración
5–12 segundos
Resolución
480p · 720p · 1080p
Relación de aspecto
9:16 · 16:9 · 1:1
Marca de agua
Ninguna en los renders de pago
Modelo
Seedance 2.0
Moderación
SeeAPI, fail-closed

Sin foto, sin deriva de cara

En el modo foto, el modelo tiene que mantener una cara subida coherente entre fotogramas. El modo texto a baile construye la figura a partir de la descripción, así que no hay una cara que se desvíe, pero la descripción tiene que sostener todo el look, desde la silueta hasta el color del vestuario.

Encuadrado para el hero point

La salida por defecto es vertical en 9:16 y de 12 segundos, lo que encaja con el point de finger-gun de la coreografía de 'Looks Can Kill': un tiempo de entrada, un gesto seco y un cierre corto. Puedes indicar en qué momento del clip cae el point.

Créditos, con precios claros

Los créditos empiezan en $9.90. Un clip estándar de 720p y 12 segundos cuesta 35 créditos, así que una recarga pequeña cubre un par de tomas. Los renders fallidos se reembolsan: no se te cobra por un clip que nunca se entregó.

Cómo funciona

  1. 1

    Cambia a texto a baile

    Abre el estudio y elige la pestaña de texto a baile en lugar de subir una foto. Tendrás dos campos de prompt: personaje y escena. No se sube nada, así que nada necesita recorte ni reiluminación previa.

  2. 2

    Escribe el personaje

    Altura, complexión, largo del pelo, un color de vestuario potente y una señal de actitud. Ejemplo: 'un bailarín alto con chaqueta roja corta y pantalones negros de pierna ancha, barbilla alta, cara de póker'. Mantén a la persona inventada: solo personajes ficticios.

  3. 3

    Escribe la escena y la cámara

    Indica el lugar, la luz y el encuadre: 'andén de metro vacío, luz cenital dura, acercamiento lento, vertical 9:16'. Di dónde cae el point —en el primer segundo o a mitad— para que el gesto no quede enterrado.

  4. 4

    Renderiza y revisa

    Renderiza un clip estándar de 720p y 12 segundos por 35 créditos; los créditos empiezan en $9.90. Si el render falla, los créditos vuelven a tu saldo y puedes afinar el prompt y volver a intentarlo.

Empieza con un prompt probado

Cada prompt es completo: sujeto, escena, cámara y lo que no debe cambiar. Cópialo o abre el estudio con él ya cargado.

Un personaje descrito con una chaqueta roja corta en pleno point de finger-gun en un pasillo iluminado con neón, renderizado como clip de baile en 9:16

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usar en el estudio

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usar en el estudio

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (inglés)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usar en el estudio

Cómo genera un clip el modo texto a baile

El modo texto a baile se salta la fase de subir una imagen. Tu prompt se lee como tres ranuras —sujeto, entorno, acción— y el modelo construye una figura coherente durante los 12 segundos completos en vez de adivinar una cara en cada fotograma. Por eso la calidad de la descripción importa más aquí que en el modo foto: nada queda fijado por una imagen de referencia.

Un render estándar es de 720p, vertical en 9:16 y 12 segundos: la forma de una subida a Reels o TikTok. Una salida más larga o más nítida cuesta más créditos. Un render fallido se reembolsa, así que una mala toma no se come tu saldo en silencio.

Qué debe incluir una descripción de personaje

Empieza por la silueta, no por el detalle. La altura, la complexión, el largo del pelo y un color de vestuario potente se leen al instante en 720p; seis accesorios se convierten en ruido borroso a ese tamaño.

Después, da una postura de la que la coreografía pueda arrancar: barbilla alta, hombros sueltos, cara de póker. El hero point es un gesto corto y seco, así que el modelo necesita una base de la que partir, no un ensayo sobre su personalidad.

Mantén al personaje en la ficción. Describe personas inventadas; no pidas un artista real, un miembro de IVE ni el parecido de nadie.

Créditos, precios y cuánto cuesta realmente un clip

Los créditos empiezan en $9.90. Un clip estándar de 720p y 12 segundos cuesta 35 créditos, así que una recarga modesta te compra un primer intento y una regrabación sin comprometerte con una suscripción que olvidarás cancelar.

Los renders fallidos se reembolsan a tu saldo, así que pagas por clips entregados, no por tiempo en cola. No se usa ninguna grabación oficial, metraje de videoclip ni parecido de miembros en ningún punto del proceso: el resultado es un personaje inventado y descrito.

Preguntas frecuentes

¿Necesito una foto para crear un clip con texto a baile?

No. El modo texto a baile toma una descripción escrita del personaje y una escena en lugar de una subida. El modo foto sigue existiendo si prefieres partir de un selfie; esta página cubre la opción sin foto.

¿Cuánto cuesta un clip?

Los créditos empiezan en $9.90. Un clip vertical estándar de 720p y 12 segundos cuesta 35 créditos. Los renders fallidos se reembolsan a tu saldo, así que un error no te cuesta créditos.

¿Incluye el audio oficial de 'Looks Can Kill'?

No. No se usa ninguna grabación oficial, metraje de videoclip ni parecido de miembros. Los clips salen en silencio o con el audio que añadas después en tu propio editor.

¿Puedo describir a una persona real, como un miembro de IVE?

No. El modo texto a baile es para personajes ficticios. No se admiten prompts que nombren artistas reales o pidan el parecido de un ídolo concreto; la tendencia a la que responde este sitio está hecha por fans y no tiene afiliación.

¿Cuánto dura y qué nitidez tiene el resultado?

Los renders estándar son de 12 segundos en 720p, en un marco vertical de 9:16: suficiente para una pasada completa de hero point con un tiempo de entrada. Los renders más largos o de mayor resolución cuestan más créditos.

¿Looks Can Kill AI es oficial?

No. Es un estudio independiente, sin afiliación con IVE ni Starship Entertainment. 'Looks Can Kill' es el tema principal del quinto EP de IVE, con el sencillo el 19 de octubre de 2026 y el EP el 26 de octubre de 2026; esta herramienta solo responde a la tendencia de baile hecha por fans que lo rodea.

Convierte tu foto en un clip

Empieza con el preset de esta página o escribe tu propio plano. Los créditos se muestran antes de generar y los renders fallidos se reembolsan.