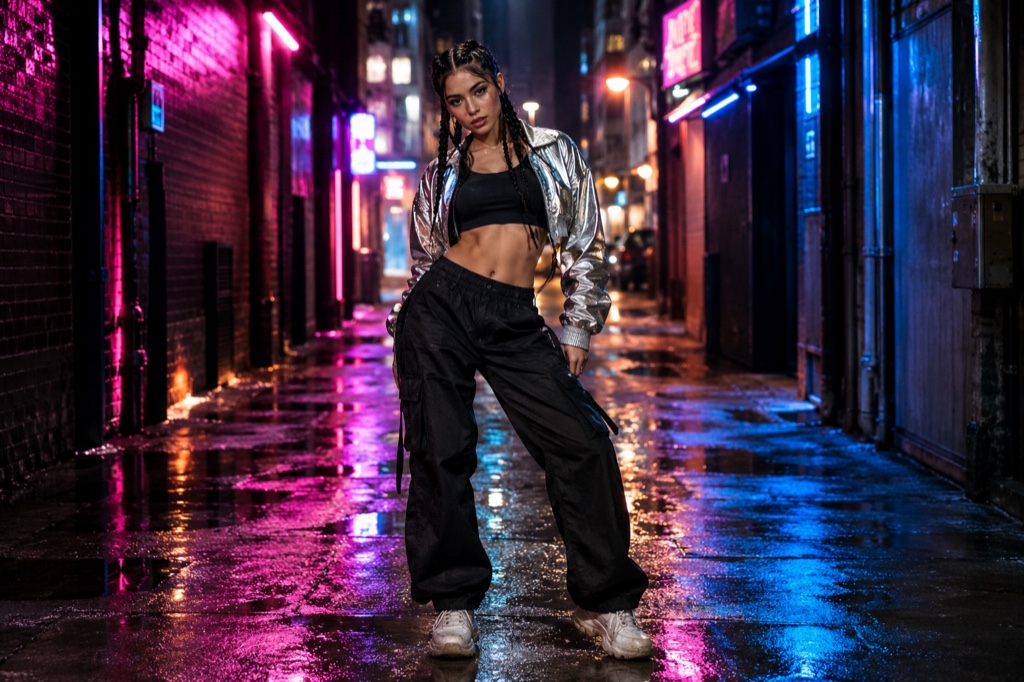
Mode texte-vers-danse · aucune photo requise

Texte en vidéo de danse : décrivez un personnage, générez un clip de danse

Le mode texte-vers-danse inverse le flux de travail habituel. Au lieu d’importer une photo en espérant que le modèle conserve le visage, vous saisissez une description de personnage — tranche d’âge, carrure, cheveux, tenue, attitude — ainsi que la scène que vous voulez autour. Le rendu transforme cette description en un court clip vertical d’une silhouette exécutant la pose héroïque de la chorégraphie de Looks Can Kill. Pas de selfie, pas d’étape de nettoyage photo, pas de doute sur l’import qui survivra au rendu.

La tendance elle-même est fan-made. Quand IVE a sorti « Looks Can Kill » comme titre principal de leur cinquième EP — single le 19 octobre 2026, EP le 26 octobre 2026 — le concept girl hero et le point du pistolet avec les doigts ont poussé les gens à se filmer en une seule prise. Le texte-vers-danse garde la forme de ce clip mais abandonne la photo source : vous inventez quelqu’un qui n’existe pas et le placez dans une scène que vous n’auriez jamais pu tourner.

Les clips de cette page sont des aperçus générés par IA. Ils sont fictifs et ne documentent pas un événement réel.

Mis à jour le 20 octobre 2026

Clip de danse vertical généré en mode texte-vers-danse à partir d’une description écrite de personnage
Durée
5–12 secondes
Résolution
480p · 720p · 1080p
Format
9:16 · 16:9 · 1:1
Filigrane
Aucun sur les rendus payants
Modèle
Seedance 2.0
Modération
SeeAPI, fail-closed

Pas de photo, pas de dérive du visage

En mode photo, le modèle doit maintenir un visage importé cohérent d’une image à l’autre. Le texte-vers-danse construit la silhouette à partir de la description : il n’y a donc pas de visage à faire dériver — mais la description doit porter tout le look, de la silhouette à la couleur de la tenue.

Cadré pour la pose héroïque

La sortie par défaut est verticale 9:16 et dure 12 secondes, ce qui convient au point du pistolet avec les doigts de la chorégraphie « Looks Can Kill » : un temps d’amorce, un geste net, une courte fin. Vous pouvez préciser où le point tombe dans le clip.

Des crédits au prix clair

Les crédits démarrent à $9.90. Un clip standard 720p de 12 secondes coûte 35 crédits : une petite recharge couvre donc quelques prises. Les rendus échoués sont remboursés — vous n’êtes pas facturé pour un clip qui n’a jamais été produit.

Comment ça marche

  1. 1

    Passez en texte-vers-danse

    Ouvrez le studio et choisissez l’onglet texte-vers-danse plutôt que l’import de photo. Vous disposez de deux champs de prompt : personnage et scène. Rien n’est importé, donc rien n’a besoin d’être recadré ou rééclairé au préalable.

  2. 2

    Écrivez le personnage

    Taille, carrure, longueur des cheveux, une couleur de tenue forte, un indice d’attitude. Exemple : « un danseur grand, veste rouge courte et pantalon noir large, menton relevé, visage impassible. » Gardez la personne inventée — personnages fictifs uniquement.

  3. 3

    Écrivez la scène et la caméra

    Nommez le lieu, la lumière et le cadrage : « quai de métro vide, lumière dure au plafond, léger travelling avant, vertical 9:16. » Précisez où tombe le point — à la première seconde ou à mi-parcours — pour que le geste ne soit pas noyé.

  4. 4

    Générez et vérifiez

    Générez un clip standard 720p de 12 secondes pour 35 crédits ; les crédits démarrent à $9.90. Si le rendu échoue, les crédits retournent sur votre solde et vous pouvez affiner le prompt et réessayer.

Partir d’un prompt testé

Chaque prompt est complet : sujet, scène, caméra et ce qui ne doit pas changer. Copiez-le ou ouvrez le studio prérempli.

Un personnage décrit, veste rouge courte, en plein point du pistolet avec les doigts dans un couloir éclairé au néon, rendu en clip de danse 9:16

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (anglais)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Utiliser dans le studio

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (anglais)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Utiliser dans le studio

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (anglais)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Utiliser dans le studio

Comment le texte-vers-danse génère un clip

Le texte-vers-danse saute l’étape d’import d’image. Votre prompt est lu comme trois emplacements — sujet, décor, action — et le modèle construit une silhouette cohérente sur les 12 secondes complètes au lieu de redéduire un visage à chaque image. C’est pourquoi la qualité de la description compte plus ici qu’en mode photo : rien n’est fixé par une image de référence.

Un rendu standard est en 720p, vertical 9:16, de 12 secondes — le format d’une publication Reels ou TikTok. Une sortie plus longue ou plus nette coûte plus de crédits. Un rendu échoué est remboursé, donc une mauvaise prise ne grignote pas votre solde en silence.

Ce qu’il faut mettre dans une description de personnage

Commencez par la silhouette, pas par le détail. Taille, carrure, longueur des cheveux et une couleur de tenue forte se lisent instantanément en 720p ; six accessoires se transforment en bruit flou à cette taille.

Ajoutez ensuite une posture dont la chorégraphie peut jaillir — menton relevé, épaules relâchées, visage impassible. La pose héroïque est un geste court et net : le modèle a besoin d’une posture de départ à rompre, pas d’un essai sur la personnalité.

Gardez le personnage fictif. Décrivez des personnes inventées ; ne demandez pas un artiste réel, un membre d’IVE ou la ressemblance de qui que ce soit.

Crédits, tarifs et coût réel d’un clip

Les crédits démarrent à $9.90. Un clip standard 720p de 12 secondes coûte 35 crédits : une recharge modeste achète un premier essai et une reprise sans vous engager dans un abonnement que vous oublierez d’annuler.

Les rendus échoués sont remboursés sur votre solde : vous payez les clips livrés, pas le temps d’attente. Aucune captation officielle, séquence de clip musical ou ressemblance de membre n’est utilisée à aucun stade du processus — le résultat est un personnage inventé et décrit.

Questions fréquentes

Faut-il une photo pour créer un clip texte-vers-danse ?

Non. Le mode texte-vers-danse prend une description écrite de personnage et une scène au lieu d’un import. Le mode photo existe toujours si vous préférez partir d’un selfie — cette page couvre le parcours sans photo.

Combien coûte un clip ?

Les crédits démarrent à $9.90. Un clip vertical standard 720p de 12 secondes coûte 35 crédits. Les rendus échoués sont remboursés sur votre solde : une erreur ne vous coûte pas de crédits.

L’audio officiel de « Looks Can Kill » est-il inclus ?

Non. Aucune captation officielle, séquence de clip musical ou ressemblance de membre n’est utilisée. Les clips sont muets ou contiennent l’audio que vous ajoutez ensuite dans votre propre logiciel de montage.

Puis-je décrire une personne réelle, comme un membre d’IVE ?

Non. Le texte-vers-danse est réservé aux personnages fictifs. Les prompts nommant des artistes réels ou demandant la ressemblance d’un idol précis ne sont pas pris en charge ; la tendance à laquelle ce site répond est fan-made et non affiliée.

Quelle est la durée et la netteté du résultat ?

Les rendus standard durent 12 secondes en 720p dans un cadre vertical 9:16 — assez pour un passage complet de pose héroïque avec un temps d’amorce. Les rendus plus longs ou en plus haute résolution coûtent plus de crédits.

Looks Can Kill AI est-il officiel ?

Non. C’est un studio indépendant, non affilié à IVE ou Starship Entertainment. « Looks Can Kill » est le titre principal du cinquième EP d’IVE, avec le single le 19 octobre 2026 et l’EP le 26 octobre 2026 ; cet outil ne répond qu’à la tendance de danse fan-made autour du morceau.

Transformez votre photo en clip

Partez du preset de cette page ou écrivez votre propre plan. Les crédits sont affichés avant la génération et les rendus échoués sont remboursés.