Pagina categoria · tool photo-to-video dance, confrontati sulle specifiche che cambiano il tuo export

AI Dance Video Generator: input, output, prezzo e watermark a confronto

La maggior parte degli "AI dance video generator" è una di due cose: un modello text-to-video che non ha mai visto un trend di danza, o un'app a template che blocca la coreografia e ti stampa un watermark sull'export. Questa pagina li confronta come sceglieresti davvero — cosa gli dai in pasto, cosa esce, quanto costa, cosa è impresso nel fotogramma e quali controlli hai prima e dopo il render.

Looks Can Kill AI sta sul versante photo-to-video: carichi una foto nitida e un breve prompt testuale e ottieni una clip verticale di quella persona che esegue l'hero point della coreografia di "Looks Can Kill" delle IVE. I crediti partono da $9.90; una clip standard di 12 secondi a 720p costa 35 crediti e i render falliti vengono rimborsati sul saldo.

I clip di questa pagina sono anteprime generate dall’IA. Sono fittizi e non documentano un evento reale.

Aggiornato il 20 ottobre 2026

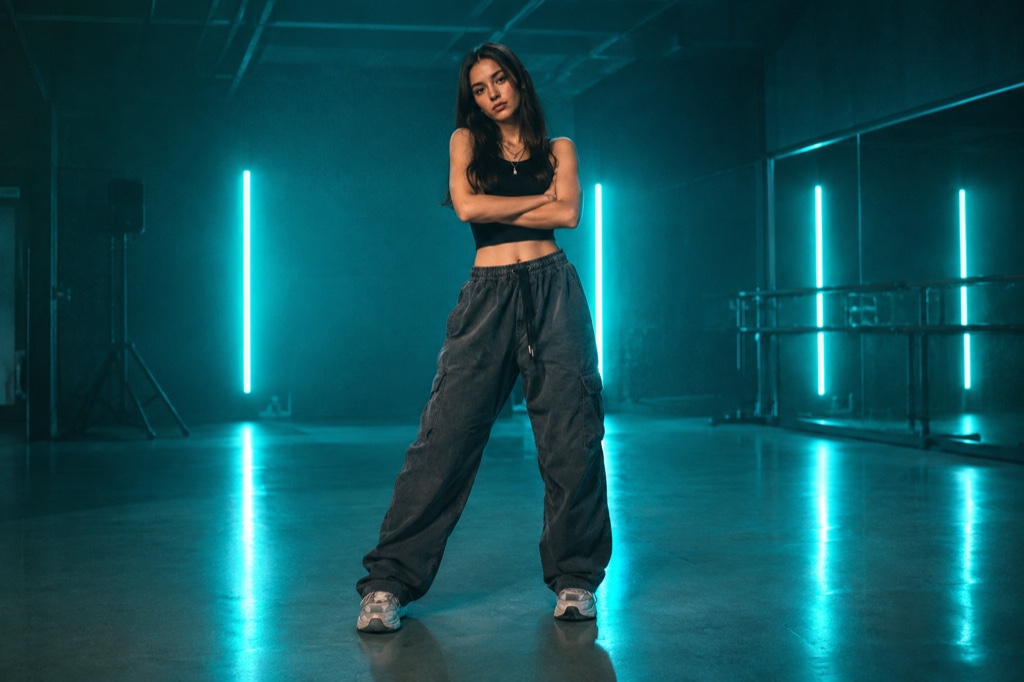
Fotogramma di anteprima verticale 9:16 di una clip di danza hero-point fan-made generata da una singola foto caricata
Durata
5–12 secondi
Risoluzione
480p · 720p · 1080p
Proporzioni
9:16 · 16:9 · 1:1
Filigrana
Nessuna sui render a pagamento
Modello
Seedance 2.0
Moderazione
SeeAPI, fail-closed

Una foto in ingresso, una clip verticale di 12 secondi in uscita

Carichi un solo scatto — niente riprese video, niente ring light, nessun setup di motion tracking — e ottieni una clip hero point a 720p in 9:16. I prompt solo testuali funzionano altrettanto bene quando non vuoi comparire nell'inquadratura.

35 crediti per clip, fallimenti rimborsati

I crediti partono da $9.90 e un render standard di 12 secondi a 720p costa 35 crediti, così puoi fare i conti prima di comprare un pacchetto. Se un render fallisce, i crediti tornano sul saldo invece di sparire in una coda.

Controllo a livello di prompt, nessun logo impresso nel fotogramma

Guidi posa, altezza della camera, energia e styling con le parole, poi rigeneri. Il sito non imprime un proprio watermark sull'export e le clip escono mute, così scegli tu l'audio quando pubblichi.

Come funziona

  1. 1

    Parti da uno scatto utilizzabile

    Una foto nitida e ben illuminata in cui si vedono viso e mani. Vanno bene sia il piano americano sia la figura intera; il point si legge meglio quando il braccio ha spazio per estendersi oltre il bordo dell'inquadratura.

  2. 2

    Descrivi l'hero point

    Nomina il movimento: mano destra a finger-gun, braccio che spinge in avanti, mento in alto, spalle squadrate, un piccolo spostamento di peso sul piede anteriore. Una camera all'altezza del petto lo fa leggere come danza e non come un ritratto.

  3. 3

    Blocca l'inquadratura

    Verticale 9:16, soggetto centrato, un po' di spazio sopra i capelli. Il render standard è 720p e 12 secondi, abbastanza per il point, lo spostamento e un battito di tenuta.

  4. 4

    Render, poi nuovo prompt

    Rivedi la clip. Se l'angolo del braccio o l'energia non vanno, modifica il prompt e rigenera — i render falliti vengono rimborsati, così una brutta posizione in coda non diventa mai un errore pagato.

Parti da un prompt collaudato

Ogni prompt è completo: soggetto, scena, camera e ciò che non deve cambiare. Copialo o apri lo studio già compilato.

Vista affiancata di un ritratto originale caricato accanto al fotogramma della clip di danza di 12 secondi generata, con il point a finger-gun

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Practice room

A practice room scene with a tighter camera and a held final pose.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Comic frame

A comic frame scene for a more graphic, stylised result.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usa nello studio

Input: cosa consegni davvero al generatore

I tool photo-to-video vogliono un solo scatto: JPEG o PNG, un viso nitido, almeno qualche centinaio di pixel di larghezza sulla testa e le mani nell'inquadratura se vuoi che il point si legga. Foto di gruppo sfocate, filtri bellezza pesanti e silhouette in controluce sono i motivi più comuni per cui un render torna morbido.

I tool text-to-video saltano la foto e costruiscono un estraneo dal tuo prompt. Va benissimo per fondali e B-roll, ma non può metterti nell'inquadratura — che è tutto il senso di una clip di tendenza.

Questo studio accetta entrambi: una foto più un prompt che descrive il movimento, oppure solo il prompt se preferisci non comparire.

Output, durata e watermark: cosa arriva nel tuo rullino

L'output standard qui è 720p verticale 9:16, 12 secondi — abbastanza per l'hero point, lo spostamento di peso e un battito di tenuta. Le clip di tendenza sono pensate per Reels, TikTok e Shorts, quindi il verticale è la norma e non un upgrade a pagamento.

Sul watermark: il sito non stampa un logo sopra il tuo fotogramma. Quando confronti i tool, chiediti se il loro è impresso nei pixel o è un overlay che puoi togliere — quella differenza conta più di quanto ammetta la maggior parte delle schede tecniche.

L'audio dell'uscita ufficiale non è incluso. Le clip vengono renderizzate senza la registrazione delle IVE e aggiungi il tuo suono nell'editor da cui già pubblichi.

Prezzo e controlli: crediti, rimborsi e quanto puoi guidare

I crediti partono da $9.90 e una clip standard di 12 secondi a 720p costa 35 crediti. I render falliti vengono rimborsati sul saldo, quindi un render che muore lato server non ti costa altro che tempo.

I controlli sono a livello di prompt, non di timeline. Guidi posa, altezza della camera, energia e styling a parole, poi rigeneri. Non c'è editor di keyframe, né rigging, né timeline da imparare prima della prima clip.

Questo è lo scambio onesto: un passaggio rapido su uno specifico momento coreografico invece della scrittura fotogramma per fotogramma. Confronta ogni generatore su questo asse, non sul suo demo reel.

Domande frequenti

È un prodotto ufficiale di IVE o Starship?

No. Looks Can Kill AI è uno studio indipendente e non è affiliato a IVE o a Starship Entertainment. "Looks Can Kill" è la title track del quinto EP delle IVE — il singolo è arrivato il 19 ottobre 2026, con l'EP il 26 ottobre 2026 — e il trend photo-to-video intorno al suo concept girl-hero è fan-made.

La clip generata include la canzone ufficiale?

No. Il sito non usa la registrazione ufficiale, il video musicale ufficiale né le sembianze dei membri, quindi i render escono muti. Aggiungi tu il brano nell'editor da cui pubblichi.

Cosa prende esattamente in input un AI dance video generator?

Due famiglie. I tool photo-to-video prendono uno scatto più una descrizione testuale del movimento; i tool text-to-video prendono solo il prompt. Qui puoi caricare una foto e dare il prompt dell'hero point, oppure andare solo testo e generare un ballerino che non sei tu.

Quanto costa una clip?

I crediti partono da $9.90 e una clip standard di 12 secondi a 720p costa 35 crediti. I render falliti vengono rimborsati sul saldo, quindi non paghi un render che non ha mai prodotto un file.

Il mio export avrà un watermark?

Il sito non mette un proprio logo sopra il fotogramma. Se vuoi la citazione a schermo, aggiungila tu — il render non imprime nulla nei pixel.

Posso mettere una membro delle IVE nella clip?

No. Lo studio non genera le sembianze dei membri. Carica una tua foto, o una che hai il permesso di usare, e dai il prompt della coreografia.

Trasforma la foto in un clip

Parti dal preset di questa pagina o scrivi la tua inquadratura. I crediti sono mostrati prima di generare e i render falliti vengono rimborsati.