Studio trend fan-made · coreografia IVE

La danza Looks Can Kill AI: una foto, un punto con pistola con le dita, 12 secondi

Il punto è tutta la mossa. “Looks Can Kill” scambia grandi ondeggiamenti delle braccia per qualcosa di più freddo: mezzo giro, uno sguardo tagliente sopra la spalla, una mano a forma di pistola con le dita e un unico punto deciso dritto verso la camera sul beat. I fan lo chiamano punto da eroina perché sembra l’ultimo fotogramma di un film d’azione. Ecco perché funziona così bene come clip AI da una sola foto: una posa chiara porta tutta l’esibizione.

Looks Can Kill AI è uno studio fan-made costruito per quel momento esatto. Carichi una foto — un selfie, uno scatto a figura intera, un fermo immagine cosplay — e il modello la ricostruisce come un corpo in movimento: spostamento del peso, rotazione delle spalle, il braccio che scatta verso l’alto nel punto. L’output è verticale 720p, dodici secondi, dimensionato per il feed dei contenuti brevi. I crediti partono da $9.90; una clip standard costa 35 crediti e i render falliti vengono rimborsati.

I clip di questa pagina sono anteprime generate dall’IA. Sono fittizi e non documentano un evento reale.

Aggiornato il 20 ottobre 2026

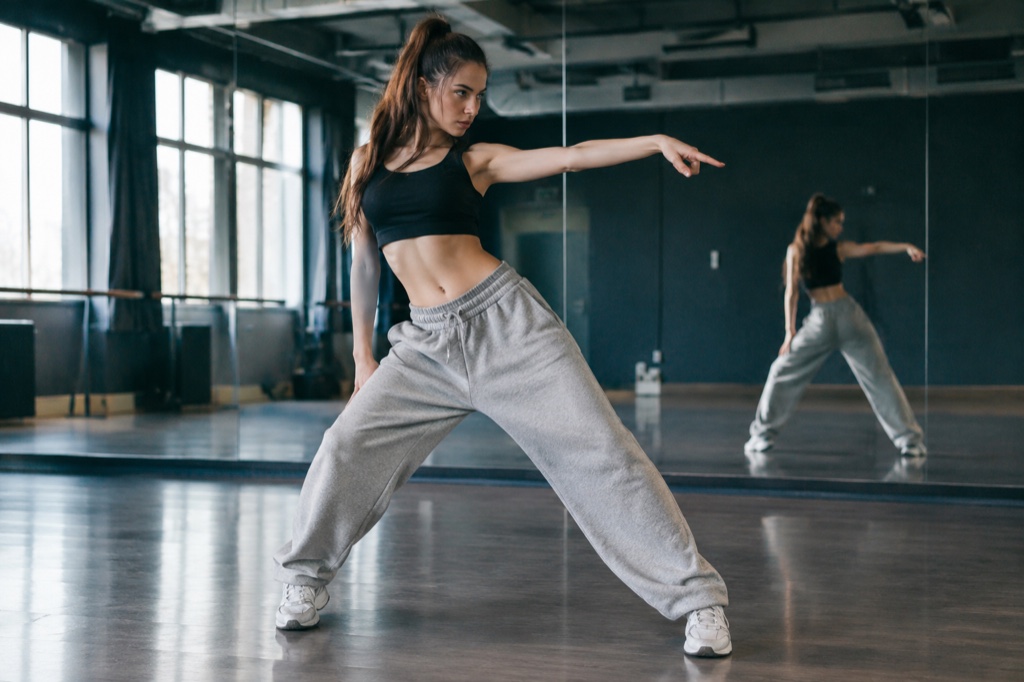
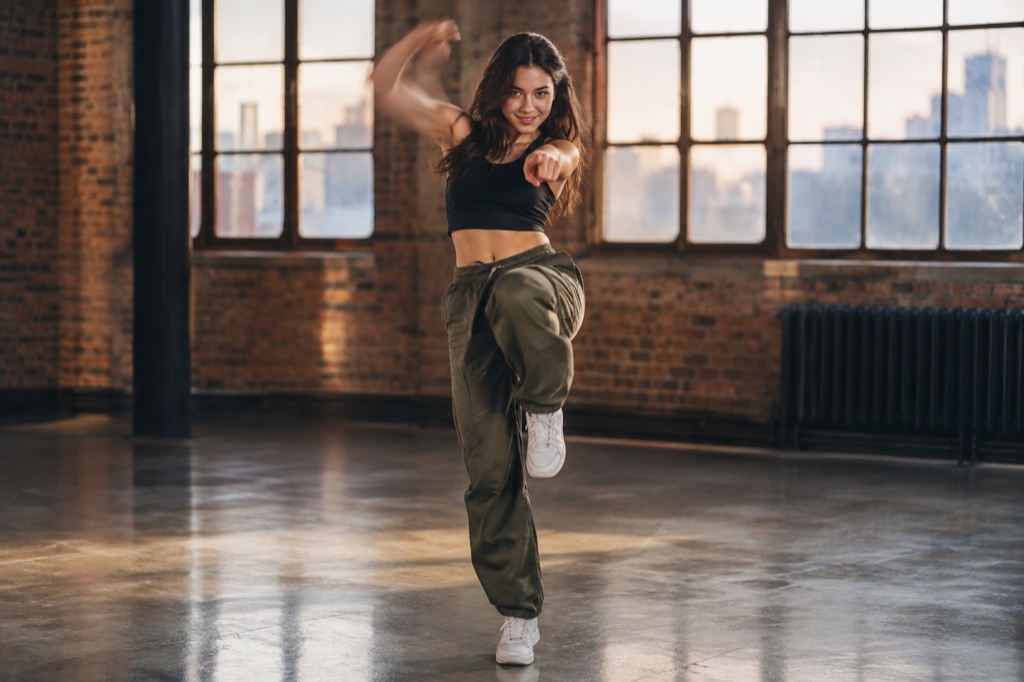
Fotogramma verticale generato dall’AI di una persona a metà del punto da eroina, mano a pistola con le dita puntata verso la camera
Durata
5–12 secondi
Risoluzione
480p · 720p · 1080p
Proporzioni
9:16 · 16:9 · 1:1
Filigrana
Nessuna sui render a pagamento
Modello
Seedance 2.0
Moderazione
SeeAPI, fail-closed

Movimento di tutto il corpo, non una testa parlante

Il render copre fianchi, postura e torso che ruota, così il punto atterra su un corpo invece di fluttuare su un viso. Verticale 9:16, 720p, dodici secondi per clip.

Prompt come indicazioni di scena

Descrivi il mezzo giro, la forma della mano e la tenuta. Istruzioni brevi e fisiche mantengono leggibile la coreografia; le routine lunghe diventano pappa.

Crediti semplici

Crediti da $9.90. Una clip standard 720p da dodici secondi costa 35 crediti e qualsiasi render fallito viene rimborsato invece di essere bruciato.

Come funziona

  1. 1

    Scegli una foto che sopravviva al movimento

    Meglio figura intera o tre quarti piuttosto che un selfie stretto. Il modello deve inventare gambe, fianchi e una spalla che ruota, quindi dagli un corpo da cui partire e lascia spazio vuoto sopra la testa e dal lato verso cui giri.

  2. 2

    Sistema le mani

    Le mani sono il punto in cui il foto-a-video cede. Scegli una fonte con mani visibili e libere, braccia staccate dal torso e senza guanti o oggetti tenuti in mano che creino una seconda silhouette. Sfondi semplici e luce uniforme aiutano la somiglianza più dei pixel.

  3. 3

    Scrivi il beat, non la canzone

    Inserisci un breve input testuale: mento che scende, mezzo giro, pistola con le dita all’altezza del petto, punto verso la camera, tenuta. Tre o quattro indicazioni fisiche battono un paragrafo che descrive un’intera routine da otto conteggi.

  4. 4

    Rivedi, poi rigenera

    Guarda prima lo slancio del braccio e il fotogramma del punto. Aspettati due o tre generazioni prima che venga pulita; i render falliti vengono rimborsati, quindi un take sbagliato costa tempo, non crediti.

Parti da un prompt collaudato

Ogni prompt è completo: soggetto, scena, camera e ciò che non deve cambiare. Copialo o apri lo studio già compilato.

Confronto affiancato tra una foto a figura intera caricata e la clip generata da 12 secondi durante la rotazione delle spalle

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Practice room

A practice room scene with a tighter camera and a held final pose.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Spotlight finale

A spotlight finale scene for a more graphic, stylised result.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A dark stage with a single warm spotlight and a thin haze in the air. The person steps into the light, crosses their arms, snaps a finger-gun point at the lens, shifts through a side step, lifts a bent leg and finishes with an arm overhead and a held final pose as the light tightens on them. One continuous vertical 9:16 shot at full-body distance, slow push-in, deep shadows and warm rim light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Il punto con pistola con le dita, diviso in beat

La mossa è una sequenza, non un fermo immagine. Conteggio uno: il mento scende, le spalle si squadrano. Conteggio due: un piccolo mezzo giro così la spalla lontana viene avanti. Conteggio tre: la mano vicina sale a forma di pistola con le dita — pollice su, indice avanti, gomito morbido. Conteggio quattro: il punto atterra verso la camera e tiene. La tenuta è la parte che la gente ricorda e che un buon render può vendere.

Ecco perché la formulazione del prompt conta. Un’intera routine descritta in prosa produce pappa; il mezzo giro, la forma della mano e la tenuta producono qualcosa che puoi davvero pubblicare. Tratta la casella di testo come indicazioni di scena per un singolo beat da eroina, non come una lista dei desideri.

Quali foto sono le migliori come fonte

Gli scatti a figura intera e a tre quarti rendono meglio dei selfie ravvicinati, perché la clip deve animare una postura e una rotazione del torso. Se ritagli, lascia aria sopra la testa e dal lato verso cui giri — il punto ha bisogno di spazio per viaggiare e il punto è la ricompensa.

Le mani decidono il take. Dita visibili, braccia staccate dal corpo, niente oggetti. Uno sfondo pulito riduce anche il rischio che il modello inventi un secondo braccio dallo schienale di una sedia o da un’ombra.

Metti in conto di rigenerare. Due o tre tentativi sono normali per qualsiasi modello foto-a-video quando un gesto specifico deve atterrare su un beat specifico.

Fan-made, e chiaro a dirlo

Questo è uno studio indipendente per il trend. Non è affiliato con IVE o Starship Entertainment e non distribuisce la registrazione ufficiale, il video musicale o la somiglianza di alcun membro. Ciò che anima è la tua foto di te.

Quindi la clip arriva muta: aggiungi il tuo audio con licenza sulla piattaforma dove pubblichi. Usa la tua somiglianza o una che hai il permesso di animare. Caricare la foto di un membro delle IVE e didascalizzare l’output come quel membro è l’unica cosa di cui questo trend non ha bisogno.

Domande frequenti

È lo strumento ufficiale di IVE o Starship?

No. Looks Can Kill AI è uno studio indipendente e fan-made. Non è affiliato con IVE o Starship Entertainment e non usa registrazioni ufficiali, video o somiglianze dei membri.

La clip include la canzone ufficiale?

Non è incluso alcun audio. Il render è un video muto della tua foto che esegue il punto, e aggiungi tu l’audio usando ciò che è concesso in licenza sulla tua piattaforma.

Quanto costa una clip?

I crediti partono da $9.90. Una clip standard 720p da dodici secondi costa 35 crediti. Se un render fallisce, quei crediti vengono rimborsati.

Posso usare un selfie invece di una foto a figura intera?

Sì, anche se i risultati sono più deboli. Un selfie costringe il modello a inventare gambe e movimento dei fianchi, cosa che spesso si vede. Gli scatti a tre quarti o a figura intera mantengono credibili il mezzo giro e la postura.

Che formato e durata ottengo?

Verticale 9:16 in 720p, dodici secondi. È la durata del beat centrale della coreografia e si adatta ai feed dei contenuti brevi senza ritagli.

Corrisponderà esattamente alla coreografia?

Approssima il punto da eroina — giro, pistola con le dita, punto, tenuta — invece di riprodurre una coreografia fedele al fotogramma. Le mani sono il punto debole abituale, quindi rigenera finché lo slancio del braccio non si legge bene.

Trasforma la foto in un clip

Parti dal preset di questa pagina o scrivi la tua inquadratura. I crediti sono mostrati prima di generare e i render falliti vengono rimborsati.