Il flusso photo-to-dance, spiegato passo per passo

Photo to Dance Video: entra una foto a figura intera, esce una clip verticale di 12 secondi

Il flusso è volutamente essenziale. Carichi una foto nitida a figura intera — in piedi, senza ostacoli, con una luce decente — e lo studio genera un'unica clip verticale di 12 secondi in cui quella persona esegue l'hero point di "Looks Can Kill". Non c'è nessuna timeline da imparare e nessun keyframe da impostare. Il verticale 9:16 è il formato predefinito perché il trend vive nei feed short-form, quindi l'inquadratura è già corretta prima che tu tocchi qualsiasi cosa.

La danza dietro il trend è la point choreography di "Looks Can Kill" delle IVE, title track del loro quinto EP — il singolo è uscito il 19 ottobre 2026, l'EP segue il 26 ottobre 2026 e l'uscita porta un concept "girl hero". La versione AI è fan-made: le persone pubblicano una foto e ottengono una breve clip di sé stesse mentre fanno l'hero point. Questo sito è indipendente e non è affiliato a IVE o Starship; non utilizza la registrazione ufficiale, il video ufficiale né le sembianze dei membri.

I clip di questa pagina sono anteprime generate dall’IA. Sono fittizi e non documentano un evento reale.

Aggiornato il 20 ottobre 2026

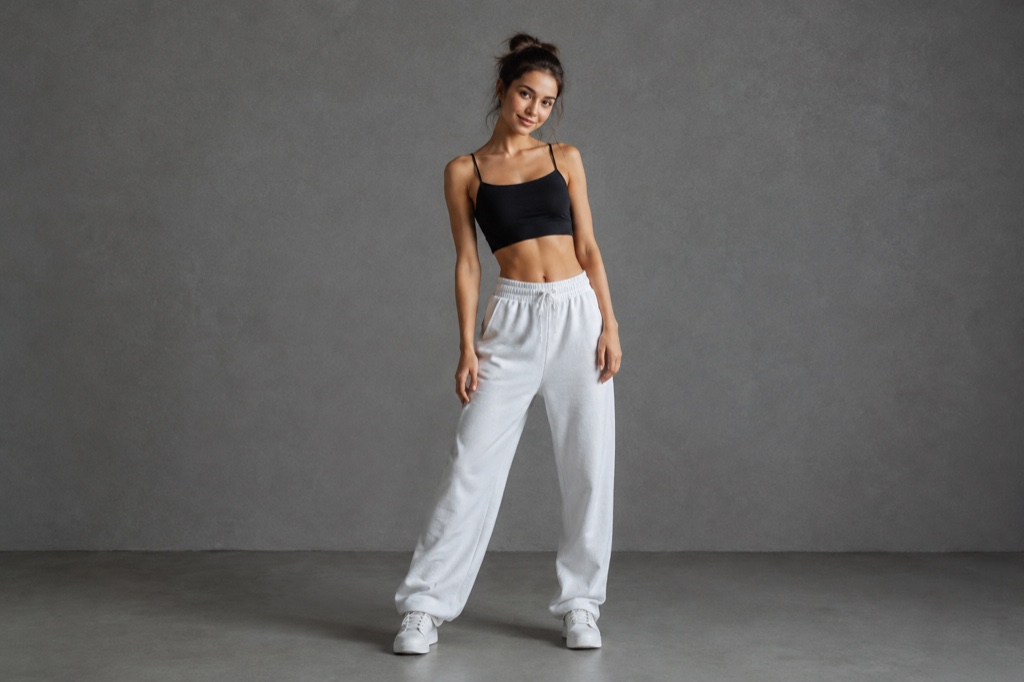
Foto a figura intera di una persona in piedi alla luce del giorno, mostrata accanto alla clip di danza verticale di 12 secondi generata
Durata
5–12 secondi
Risoluzione
480p · 720p · 1080p
Proporzioni
9:16 · 16:9 · 1:1
Filigrana
Nessuna sui render a pagamento
Modello
Seedance 2.0
Moderazione
SeeAPI, fail-closed

Progettato intorno a una sola foto

La maggior parte dei tool video vuole un set di immagini, una sceneggiatura o una clip da animare. Questo è costruito per l'input più piccolo possibile: uno scatto a figura intera in cui si vedono tutto il corpo ed entrambe le braccia. È questo vincolo a rendere il risultato leggibile in 9:16 — il modello ha un soggetto pulito da cui partire invece di tirare a indovinare.

Dodici secondi, verticale, niente da montare

L'output è una clip fissa di 12 secondi in 9:16, la durata che il trend usa davvero su Shorts, Reels e TikTok. Non devi tagliare, ritagliare né aggiungere una timeline. La scarichi, la carichi nell'app ed è già a tutto schermo come una danza girata col telefono.

Crediti a clip, rimborsati in caso di errore

I crediti partono da $9.90. Una clip standard di 12 secondi a 720p costa 35 crediti, così puoi calcolare il costo per tentativo prima di comprare qualsiasi cosa. Se un render fallisce, i crediti di quel render vengono rimborsati — non paghi una clip che non hai mai ricevuto.

Come funziona

  1. 1

    1. Scegli una foto a figura intera

    Scegli una foto in cui sei in piedi, dalla testa ai piedi nell'inquadratura, con le braccia staccate dal busto e luce frontale. Evita pose sedute, foto di gruppo, ombre pesanti e qualsiasi scatto tagliato alle ginocchia. Sfondi neutri e abiti semplici danno al modello meno cose da fraintendere.

  2. 2

    2. Caricala

    Trascina il file nello studio. Il tool legge la posa del corpo dalla foto e vi mappa sopra il movimento della danza, quindi più la posa è chiara, più il movimento è pulito. Se la foto è tagliata o coperta, cambiala prima di spendere crediti.

  3. 3

    3. Genera la clip di 12 secondi

    Avvia il render. Ottieni una clip verticale 9:16 a 720p in cui la persona della foto esegue la coreografia dell'hero point — gesti finger-gun e point inclusi. Controlla prima mani e piedi: sono i punti in cui di solito compaiono i piccoli artefatti.

  4. 4

    4. Scarica e pubblica

    Salva l'MP4 e caricalo sul feed su cui pubblichi. Se vuoi un secondo tentativo da un'altra foto, è un render separato e un addebito separato di 35 crediti — non c'è un abbonamento per foto incluso di default.

Parti da un prompt collaudato

Ogni prompt è completo: soggetto, scena, camera e ciò che non deve cambiare. Copialo o apri lo studio già compilato.

Vista affiancata di un ritratto a figura intera caricato e della clip verticale 9:16 della stessa persona che esegue un hero point a finger-gun

Practice room

A practice room scene that keeps the face and outfit from your photo.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Spotlight finale

A spotlight finale scene with a tighter camera and a held final pose.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A dark stage with a single warm spotlight and a thin haze in the air. The person steps into the light, crosses their arms, snaps a finger-gun point at the lens, shifts through a side step, lifts a bent leg and finishes with an arm overhead and a held final pose as the light tightens on them. One continuous vertical 9:16 shot at full-body distance, slow push-in, deep shadows and warm rim light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Rooftop hero

A rooftop hero scene for a more graphic, stylised result.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Che tipo di foto funziona davvero

Il fattore che incide di più sulla qualità dell'output è la foto di input, non il prompt. Scatta o scegli un fotogramma in cui sei dritto, con i piedi visibili e le braccia leggermente staccate dal corpo, così che la silhouette sia leggibile. Vanno bene sia la vista frontale sia un leggero tre quarti; gli angoli estremi e gli arti in forte scorcio no.

La luce conta più della risoluzione. Una foto da telefono con luce diurna uniforme batte uno scatto da 40 megapixel con metà viso in ombra. Evita sfondi caotici, fantasie pesanti e qualsiasi cosa che si sovrapponga al tuo contorno — il modello deve separarti dalla scena prima di poterti muovere.

Ritaglia abbastanza stretto da riempire la maggior parte dell'inquadratura in verticale, ma lascia un po' di spazio sopra la testa. Una persona che occupa il 20% di una foto panoramica dà al modello pochissimo materiale quando riquadra in 9:16.

Cos'è la clip — e cosa non è

L'output è un'animazione di danza generata della persona nella tua foto che esegue i gesti finger-gun e point associati al trend. È una clip verticale breve, dall'effetto loop, non una spiegazione completa della coreografia, e non riproduce il video musicale ufficiale inquadratura per inquadratura.

Non è incluso alcun audio ufficiale. Il sito non usa la registrazione delle IVE, il video ufficiale né le sembianze di nessun membro. Generi movimento dalla tua foto e aggiungi il suono che hai il diritto di usare quando pubblichi.

È uno strumento fan-made indipendente. Non è affiliato a IVE o a Starship Entertainment e non pretende di essere un prodotto ufficiale del gruppo o dell'etichetta.

Costi, crediti e nuovi tentativi

Il prezzo è per render, non mensile. I crediti partono da $9.90 e una clip standard di 12 secondi a 720p costa 35 crediti, quindi una singola ricarica copre un numero prevedibile di tentativi. Niente si rinnova a tua insaputa.

I render falliti vengono rimborsati in crediti, il che significa che un minuto di server sfortunato non si mangia il tuo saldo. Un render riuscito ma che personalmente non ti piace è un normale tentativo pagato — ed è per questo che conviene partire da una foto che rispetti la checklist qui sopra.

Se stai provando più foto, metti in budget due o tre tentativi invece di uno. Gli scatti a figura intera variano molto, e la differenza tra un input buono e uno ottimo si vede nelle mani e nei piedi.

Domande frequenti

È uno strumento ufficiale di IVE o Starship?

No. Looks Can Kill AI è uno studio fan-made indipendente. Non è affiliato, approvato o collegato a IVE o a Starship Entertainment e non utilizza video ufficiali, la registrazione ufficiale né le sembianze dei membri.

Il video include la canzone?

No. Il render produce solo movimento generato, senza audio. Non è incluso alcun audio ufficiale, registrazione o footage del video musicale, quindi aggiungi tu il suono, tra quelli che hai il diritto di usare sulla piattaforma dove pubblichi.

Quale foto devo caricare per il risultato migliore?

Una foto nitida a figura intera: in piedi, dalla testa ai piedi, braccia leggermente staccate dal corpo, luce frontale uniforme, sfondo semplice. Evita pose sedute, gambe tagliate, foto di gruppo e ombre nette sul viso.

Quanto costa una clip?

I crediti partono da $9.90 e una clip standard di 12 secondi a 720p costa 35 crediti. Dato che si paga a crediti e non in abbonamento, puoi calcolare il costo dei tentativi extra prima di spendere.

Perché la clip è fissa a 12 secondi e verticale?

È il formato che il trend usa. I feed short-form premiano il 9:16 e una durata che si esaurisce prima che qualcuno scorra. Fissare entrambi significa nessun passaggio di ritaglio o taglio tra render e pubblicazione.

Cosa succede se un render fallisce?

I render falliti vengono rimborsati automaticamente in crediti, quindi un problema tecnico non ti costa una clip. Un render riuscito che semplicemente non ti piace viene trattato come un normale tentativo pagato.

Trasforma la foto in un clip

Parti dal preset di questa pagina o scrivi la tua inquadratura. I crediti sono mostrati prima di generare e i render falliti vengono rimborsati.