Fan-made · indipendente · non affiliato a IVE o Starship

Kpop Dance AI: il linguaggio visivo della point choreography K-pop, tradotto in una sola foto

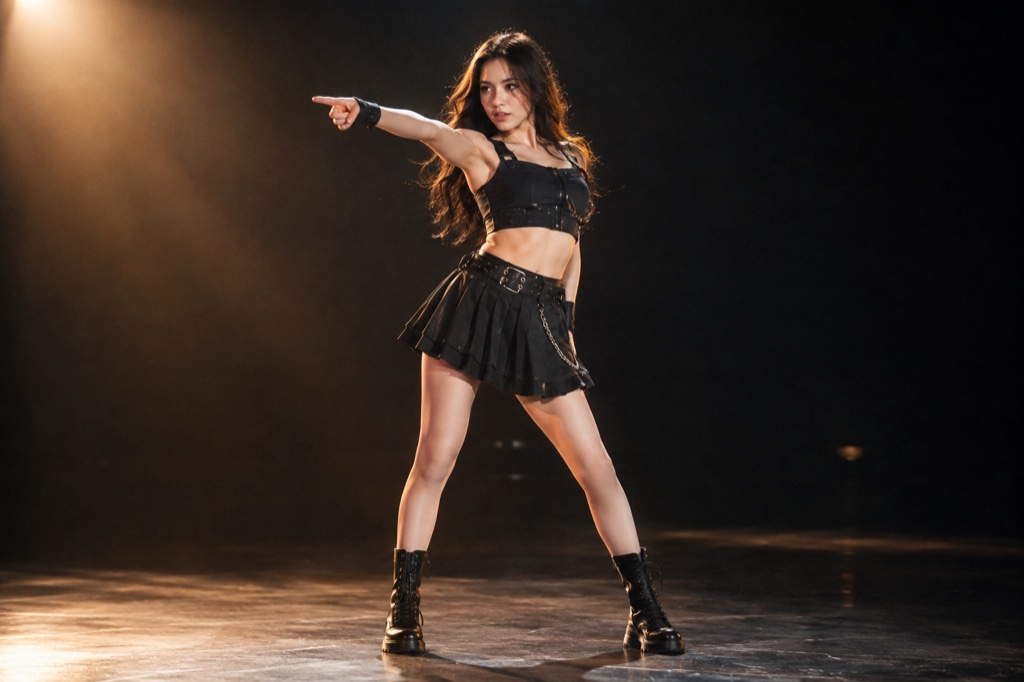
La point choreography K-pop è costruita per la seconda camera. Un blocco di spalla, uno scatto di polso, un finger-gun puntato dritto verso l'obiettivo — il movimento che una fancam ripete in loop per tre settimane. "Looks Can Kill" delle IVE si appoggia forte a questa logica con il suo concept girl-hero, e il trend fan intorno è ancora più semplice: una foto in ingresso, una breve clip verticale in uscita, tu che fai l'hero point. Nessuna routine da memorizzare, nessun gruppo con cui sincronizzarsi.

Quello che segue è un'analisi di questa grammatica visiva — linee inquadrate, timing hit-and-hold, la silhouette hero — e di come un flusso a foto singola la riproduca senza uno studio di danza. Carichi un'immagine, descrivi il movimento dell'hero point a parole e lo studio genera una clip verticale a 720p di 12 secondi per 35 crediti. I crediti partono da $9.90, i render falliti vengono rimborsati e nulla qui usa la registrazione ufficiale o le sembianze dei membri.

I clip di questa pagina sono anteprime generate dall’IA. Sono fittizi e non documentano un evento reale.

Aggiornato il 20 ottobre 2026

Fotogramma verticale 9:16 di una ballerina a metà hero point, un braccio esteso verso la camera in un gesto finger-gun, illuminata frontalmente su un palco scuro
Durata
5–12 secondi
Risoluzione
480p · 720p · 1080p
Proporzioni
9:16 · 16:9 · 1:1
Filigrana
Nessuna sui render a pagamento
Modello
Seedance 2.0
Moderazione
SeeAPI, fail-closed

L'unità è il point move, non la routine

Questo studio non prova a ricostruire un'intera sequenza da trenta secondi. Punta al gesto che porta la canzone — per "Looks Can Kill", l'hero point a finger-gun — e lo tiene abbastanza a lungo da leggersi su uno schermo tenuto a distanza di braccio.

Un'immagine, nessun video di riferimento

Non carichi footage di te che balli né replichi la fancam di una membro fotogramma per fotogramma. Una sola foto nitida, più una breve descrizione testuale del movimento, è tutto l'input. La foto fornisce corpo, outfit e luce; il testo fornisce il movimento.

Prezzo per clip, rimborso in caso di errore

Una clip verticale standard di 12 secondi a 720p costa 35 crediti e i crediti partono da $9.90. Se un render fallisce, quei crediti tornano sul tuo saldo — paghi per un output utilizzabile, non per i tentativi.

Come funziona

  1. 1

    Carica una foto

    Scegli uno scatto nitido a figura intera o a tre quarti con le mani visibili e non tagliate. Una luce frontale uniforme e uno sfondo neutro danno al modello una silhouette più pulita da animare rispetto a una scena caotica o a un selfie dal basso.

  2. 2

    Descrivi l'hero point

    Scrivi il gesto come lo chiamerebbe un coreografo: quale braccio parte verso l'obiettivo, dove scatta il polso, se il petto è sollevato e il mento abbassato, quanto ruotano le spalle sull'accento. Due o tre righe specifiche battono un paragrafo di parole d'atmosfera.

  3. 3

    Genera la clip di 12 secondi

    Lo studio produce un video verticale a 720p in 9:16 — il ritaglio nativo per il trend — a 35 crediti per render standard. Nessun montaggio su timeline, nessun keyframe, nessuna seconda app.

  4. 4

    Rivedi e rigenera

    Guarda prima mani, polsi e attaccatura dei capelli: è lì che l'image-to-video si rompe. Se un passaggio fallisce del tutto, i crediti vengono rimborsati. Se il render riesce ma il gesto è debole, stringi la descrizione e rilancia.

Parti da un prompt collaudato

Ogni prompt è completo: soggetto, scena, camera e ciò che non deve cambiare. Copialo o apri lo studio già compilato.

Esempio affiancato: a sinistra un singolo ritratto caricato, a destra la clip verticale a 720p di 12 secondi generata, colta a metà point choreography

Spotlight finale

A spotlight finale scene that keeps the face and outfit from your photo.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A dark stage with a single warm spotlight and a thin haze in the air. The person steps into the light, crosses their arms, snaps a finger-gun point at the lens, shifts through a side step, lifts a bent leg and finishes with an arm overhead and a held final pose as the light tightens on them. One continuous vertical 9:16 shot at full-body distance, slow push-in, deep shadows and warm rim light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Practice room

A practice room scene with a tighter camera and a held final pose.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Comic frame

A comic frame scene for a more graphic, stylised result.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usa nello studio

Cosa rende leggibile la point choreography K-pop su un telefono

La point choreography è un'abitudine alla compressione. Una title track si costruisce intorno a due o tre gesti che sopravvivono a un ritaglio nove per sedici: una linea pulita dalla spalla alla punta delle dita, un hit che cade sul chop vocale, una silhouette che chi guarda può copiare allo specchio di camera sua. Tutto il resto è tessuto connettivo.

"Looks Can Kill" spinge il tutto in un registro girl-hero — mento giù, petto aperto, finger-gun puntato verso l'obiettivo. Il gesto è leggibile in un solo fotogramma, ed è esattamente per questo che un flusso a una foto può riprodurlo mentre una routine completa no.

Come un'immagine ferma trasporta un gesto in movimento

La tua foto risponde alle domande statiche: forma del corpo, abbigliamento, capelli, dove cade la luce, come stanno le spalle. Il testo risponde a quelle dinamiche: quale braccio si estende, quanto velocemente ruota il polso, se il peso si sposta sul piede anteriore sull'accento.

Tenere la clip a dodici secondi è un vincolo voluto. Battute brevi e un verticale stretto mantengono l'inquadratura sulla parte alta del corpo, dove vivono davvero i point move — e dove gli artefatti sugli arti hanno meno probabilità di saltare fuori.

I limiti onesti della K-pop dance AI fan-made

Non è un tutorial di danza, non è un'uscita ufficiale e non è affiliato a IVE o a Starship Entertainment. Non include la registrazione ufficiale, il video ufficiale né le sembianze di alcun membro. L'output è un file video muto; aggiungi altrove l'audio di cui detieni i diritti.

Le rotazioni veloci del polso e le dita sovrapposte restano la parte fragile di qualsiasi modello image-to-video. Parti da una foto in cui le mani sono già visibili e ben illuminate, tieni il gesto abbastanza lento da leggersi e metti in conto un secondo passaggio prima che il point venga pulito.

Domande frequenti

È uno strumento ufficiale di IVE o Starship?

No. Looks Can Kill AI è uno studio indipendente e fan-made. Non è affiliato, approvato o collegato a IVE o a Starship Entertainment e non utilizza la registrazione ufficiale, il video musicale né le sembianze dei membri.

La clip include l'audio di "Looks Can Kill"?

Non è incluso alcun audio ufficiale. Ricevi un file video verticale muto a 720p e puoi aggiungere il suono che hai il diritto di usare nel tuo editor.

Quanto costa davvero una clip?

I crediti partono da $9.90. Una clip verticale standard di 12 secondi a 720p costa 35 crediti e qualsiasi render che fallisce viene rimborsato sul saldo, quindi un output rotto non ti costa mai crediti.

Devo già conoscere la coreografia?

No. Descrivi il gesto in parole semplici — direzione del braccio, scatto del polso, dove guardi — e lo studio lo traduce in movimento. Conoscere il point ti aiuta a scrivere una descrizione più precisa, ma non devi mai esibirti davanti alla camera.

Quale foto dà il risultato migliore?

Uno scatto nitido a figura intera o a tre quarti, mani visibili, luce frontale uniforme e uno sfondo che non compete con la tua silhouette. Evita angolazioni estreme, mani tagliate e motion blur pesante: è lì che polsi e dita cedono per primi.

Posso caricare la foto di una membro delle IVE o di un amico?

Carica solo immagini che hai il diritto di usare — normalmente le tue. Le sembianze dei membri non vengono usate da nessuna parte su questo sito e generare clip di altre persone senza il loro permesso non è lo scopo dello studio.

Trasforma la foto in un clip

Parti dal preset di questa pagina o scrivi la tua inquadratura. I crediti sono mostrati prima di generare e i render falliti vengono rimborsati.