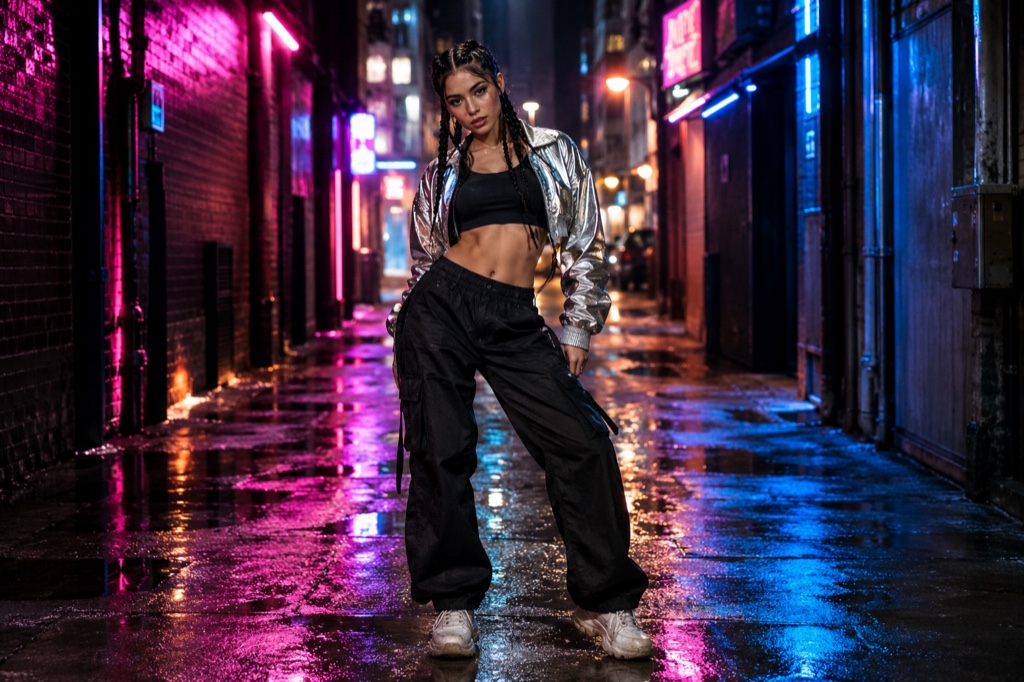
Modalità text-to-dance · nessuna foto richiesta

Text to Dance Video: descrivi un personaggio, renderizza una clip dance

La modalità text-to-dance ribalta il flusso di lavoro usuale. Invece di caricare una foto e sperare che il modello mantenga il volto, scrivi una descrizione del personaggio — fascia d'età, corporatura, capelli, outfit, atteggiamento — più la scena che vuoi attorno. Il render trasforma quella descrizione in una breve clip verticale di una figura che esegue l'hero point della coreografia di Looks Can Kill. Niente selfie, nessuna fase di pulizia della foto, nessun dubbio su quale upload sopravviverà al render.

Il trend in sé è fan-made. Quando IVE ha pubblicato "Looks Can Kill" come title track del loro quinto EP — singolo il 19 ottobre 2026, EP il 26 ottobre 2026 — il concept girl-hero e il point finger-gun hanno spinto le persone a filmarsi in un'unica ripresa. Text-to-dance mantiene la forma di quella clip ma elimina la foto di partenza: inventi qualcuno che non esiste e lo metti in una scena che non avresti mai modo di girare.

I clip di questa pagina sono anteprime generate dall’IA. Sono fittizi e non documentano un evento reale.

Aggiornato il 20 ottobre 2026

Clip dance verticale generata in modalità text-to-dance da una descrizione scritta del personaggio
Durata
5–12 secondi
Risoluzione
480p · 720p · 1080p
Proporzioni
9:16 · 16:9 · 1:1
Filigrana
Nessuna sui render a pagamento
Modello
Seedance 2.0
Moderazione
SeeAPI, fail-closed

Niente foto, nessun face drift

In modalità foto il modello deve mantenere un volto caricato coerente tra i frame. Text-to-dance costruisce invece la figura dalla descrizione, quindi non c'è un volto che possa andare alla deriva — ma la descrizione deve sostenere l'intero look, dalla silhouette al colore dell'outfit.

Inquadrata per l'hero point

L'output predefinito è verticale 9:16 e 12 secondi, ideale per il finger-gun point della coreografia di "Looks Can Kill": un beat di introduzione, un gesto netto, una breve coda. Puoi indicare in quale punto della clip cade il point.

Crediti, con prezzi chiari

I crediti partono da $9.90. Una clip standard 720p da 12 secondi costa 35 crediti, quindi una piccola ricarica copre un paio di take. I render non riusciti vengono rimborsati — non paghi per una clip che non è mai stata prodotta.

Come funziona

  1. 1

    Passa a text-to-dance

    Apri lo studio e seleziona la scheda text-to-dance invece del caricamento foto. Ottieni due campi prompt: personaggio e scena. Non viene caricato nulla, quindi niente da ritagliare o da rielaborare l'illuminazione prima.

  2. 2

    Scrivi il personaggio

    Altezza, corporatura, lunghezza dei capelli, un colore forte dell'outfit, un dettaglio di atteggiamento. Esempio: "una ballerina alta con giacca rossa corta e pantaloni neri a gamba larga, mento in su, espressione impassibile." Mantieni la persona inventata — solo personaggi di fantasia.

  3. 3

    Scrivi la scena e la camera

    Indica il luogo, la luce e l'inquadratura: "banchina della metropolitana vuota, luce dura dall'alto, lento push-in, verticale 9:16." Specifica dove cade il point — al primo secondo o a metà — così il gesto non si perde.

  4. 4

    Renderizza e controlla

    Renderizza una clip standard 720p da 12 secondi per 35 crediti; i crediti partono da $9.90. Se il render non riesce, i crediti tornano sul saldo e puoi rifinire il prompt e riprovare.

Parti da un prompt collaudato

Ogni prompt è completo: soggetto, scena, camera e ciò che non deve cambiare. Copialo o apri lo studio già compilato.

Un personaggio descritto con giacca rossa corta nel bel mezzo di un finger-gun point in un corridoio illuminato al neon, renderizzato come clip dance 9:16

Rooftop hero

A rooftop hero scene that keeps the face and outfit from your photo.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. Night rooftop above a glowing city skyline, a light breeze moving their hair and jacket. The person walks two steps toward the lens, crosses their arms, snaps a finger-gun hand toward the camera, points at the lens, shifts their weight through a sharp side step, lifts one bent leg, raises an arm overhead and settles into a wide action-hero stance with one final point. One continuous vertical 9:16 shot at full-body distance, a slight low angle, cinematic teal and amber light, slow motion on the snap. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Comic frame

A comic frame scene with a tighter camera and a held final pose.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit recognisable, then render the whole shot as an original comic-book hero sequence: bold ink outlines, flat cel shading, halftone texture and graphic speed lines. The person crosses their arms, fires a finger-gun point at the lens, snaps once, steps into a wide stance, raises an arm overhead and holds a hero pose. One continuous vertical 9:16 shot at full-body distance, dramatic low angle, limited palette of deep navy, warm yellow and off-white. Original character art only: no existing comic characters, no real celebrities, no text, no watermark, no logos.

Usa nello studio

Practice room

A practice room scene for a more graphic, stylised result.

Prompt (inglese)

Use the person in the uploaded photo as the only hero. Keep their face, hair, skin tone and outfit exactly as photographed. A bright dance practice room with a mirrored wall, pale wooden floor and soft daylight. The person faces the mirror, then turns to the camera: they roll their shoulders, cross their arms near the face, snap a finger-gun point at the lens, take a quick side step, lift a bent leg and finish with an arm raised overhead. One continuous vertical 9:16 shot at full-body distance, handheld camera with a gentle push-in, clean natural light. No text, no watermark, no other people, no real celebrities, no logos.

Usa nello studio

Come text-to-dance renderizza una clip

Text-to-dance salta la fase di caricamento immagine. Il tuo prompt viene letto come tre slot — soggetto, ambientazione, azione — e il modello costruisce una figura coerente per tutti i 12 secondi invece di rivedere il volto a ogni frame. Ecco perché la qualità della descrizione conta più qui che in modalità foto: nulla è fissato da un'immagine di riferimento.

Un render standard è 720p, verticale 9:16, 12 secondi — la forma di un upload per Reels o TikTok. Un output più lungo o più nitido costa più crediti. Un render non riuscito viene rimborsato, quindi un take sbagliato non erode silenziosamente il saldo.

Cosa deve contenere la descrizione di un personaggio

Parti dalla silhouette, non dal dettaglio. Altezza, corporatura, lunghezza dei capelli e un colore forte dell'outfit si leggono subito a 720p; sei accessori diventano rumore confuso a quella dimensione.

Poi dai una postura da cui la coreografia possa scattare — mento in su, spalle rilassate, espressione impassibile. L'hero point è un gesto breve e netto, quindi il modello ha bisogno di una posizione da cui partire, non di un tema sulla personalità.

Mantieni il personaggio di fantasia. Descrivi persone inventate; non chiedere un performer reale, un membro delle IVE o la somiglianza di qualcuno.

Crediti, prezzi e quanto costa davvero una clip

I crediti partono da $9.90. Una clip standard 720p da 12 secondi costa 35 crediti, quindi una ricarica modesta copre un primo tentativo e un nuovo shoot senza impegnarti in un abbonamento che poi dimenticherai di disdire.

I render non riusciti vengono rimborsati sul saldo, quindi paghi per le clip consegnate, non per il tempo in coda. Nessuna registrazione ufficiale, footage di videoclip o somiglianza dei membri viene usata in nessuna fase della pipeline — l'output è un personaggio inventato e descritto.

Domande frequenti

Serve una foto per creare una clip text-to-dance?

No. La modalità text-to-dance accetta una descrizione scritta del personaggio e una scena invece di un caricamento. La modalità foto esiste ancora se preferisci partire da un selfie — questa pagina copre il percorso senza foto.

Quanto costa una clip?

I crediti partono da $9.90. Una clip verticale standard 720p da 12 secondi costa 35 crediti. I render non riusciti vengono rimborsati sul saldo, quindi un errore non ti costa crediti.

L'audio ufficiale di "Looks Can Kill" è incluso?

No. Non vengono usati registrazioni ufficiali, footage di videoclip o somiglianze dei membri. Le clip sono mute o contengono l'audio che aggiungi in seguito nel tuo editor.

Posso descrivere una persona reale, come un membro delle IVE?

No. Text-to-dance è per personaggi di fantasia. I prompt che nominano performer reali o richiedono la somiglianza di un idol specifico non sono supportati; il trend a cui questo sito risponde è fan-made e non affiliato.

Quanto è lunga e quanto è nitida l'output?

I render standard sono da 12 secondi a 720p in un frame verticale 9:16 — abbastanza per un passaggio completo dell'hero point con un beat di introduzione. Render più lunghi o ad alta risoluzione costano più crediti.

Looks Can Kill AI è ufficiale?

No. È uno studio indipendente, non affiliato a IVE o Starship Entertainment. "Looks Can Kill" è la title track delle IVE dal loro quinto EP, con il singolo il 19 ottobre 2026 e l'EP il 26 ottobre 2026; questo strumento risponde solo al trend dance fan-made che ci ruota attorno.

Trasforma la foto in un clip

Parti dal preset di questa pagina o scrivi la tua inquadratura. I crediti sono mostrati prima di generare e i render falliti vengono rimborsati.