Modalità testo-a-video: descrivi un personaggio e una scena di fantasia senza una foto
 Looks Can Kill AI Team
Scopri come usare la modalità testo-a-video per descrivere un personaggio e una scena originali senza caricare una foto. Consigli pratici sui prompt per Looks Can Kill AI, basato su Seedance 2.0.
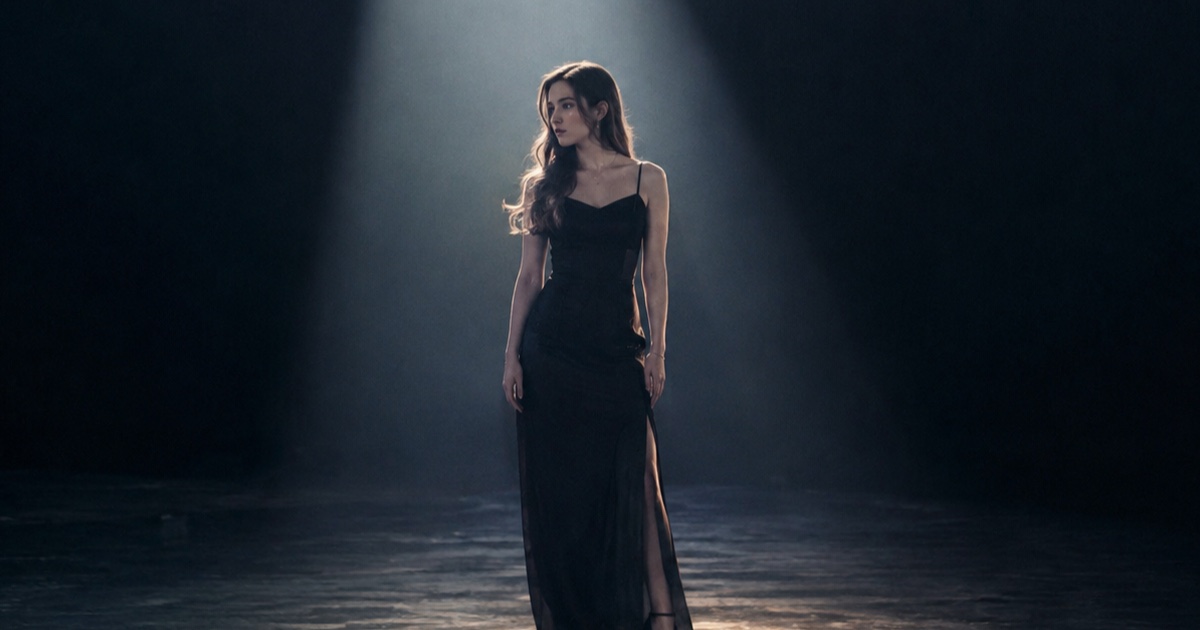
La modalità testo-a-video è pensata per i momenti in cui desideri una clip ma non vuoi caricare una foto. Invece di partire da un'immagine, descrivi un personaggio di fantasia e la scena che lo circonda. Looks Can Kill AI è uno studio indipendente di foto/testo-a-video basato su Seedance 2.0. Non è affiliato a IVE o Starship Entertainment. Se decidi di caricare una foto, puoi caricare solo una tua foto o una foto di cui hai il permesso di utilizzo. La modalità testo-a-video ti permette di saltare del tutto questo passaggio e di lavorare a partire da una descrizione scritta.
Questa guida si concentra sui personaggi originali. IVE è un gruppo femminile K-pop sotto Starship Entertainment, e “Looks Can Kill” è la title track del loro quinto EP; il singolo è uscito il 19 ottobre 2026 e l'EP arriva il 26 ottobre 2026. L'uscita utilizza un concept da eroina e una coreografia finger-gun / point. Puoi usarla come riferimento d'atmosfera per un personaggio originale, ma non descrivere un membro reale né caricare una foto che non hai il permesso di usare. Lo studio non include la registrazione ufficiale, il video ufficiale o le sembianze dei membri. Per il contesto sull'uscita, vedi che cos'è IVE Looks Can Kill AI.
La difficoltà pratica è che un prompt testuale deve svolgere il lavoro che di norma farebbe una foto. Devi specificare chi è il personaggio, cosa indossa, come si muove, dove si trova e come lo vede la camera. Più separi chiaramente questi livelli, più facile sarà ottenere una clip utilizzabile.
Example loaded — edit it or generate.
This clip: 35 credits · 10 clips a month for $39.90 (Pro), or 102 a year for $319
Perché la modalità testo-a-video è utile per i personaggi di fantasia
La modalità testo-a-video non sostituisce ogni flusso di lavoro basato su foto. È un punto di partenza diverso. Se hai già una foto di una persona che possiedi o che hai il permesso di usare, foto-a-video può preservare quell'aspetto specifico. Se stai progettando un personaggio da zero, testo-a-video mantiene il processo flessibile. Puoi cambiare costume, scena e angolazione della camera senza bisogno di una nuova immagine di partenza.
È utile anche quando vuoi evitare questioni legate alle sembianze di persone reali. Un prompt dovrebbe descrivere un personaggio originale, non un artista reale. Usa ruolo, silhouette, costume, colore e atteggiamento invece di “qualcuno che somiglia a” una persona con un nome.
Come descrivere un personaggio di fantasia
La descrizione di un personaggio funziona meglio quando passa dalla forma generale ai piccoli dettagli. Inizia dal ruolo e dalla silhouette, poi aggiungi costume, colore, viso, capelli, espressione e movimento. In questo modo offri al modello un soggetto coerente invece di un mucchio di aggettivi scollegati.
Parti dal ruolo e dalla silhouette
Inizia con un ruolo chiaro e una corporatura chiara. Per esempio: “un giovane eroe immaginario”, “un artista di strada mascherato” o “un corriere sicuro di sé in una città futuristica”. Poi aggiungi indicazioni sulla silhouette: alto e snello, compatto e atletico, dalle spalle larghe o leggero nei movimenti. Questo è importante perché il modello deve sapere come il personaggio occupa lo spazio prima di poterlo animare.
Se vuoi un'atmosfera da eroina ispirata all'uscita delle IVE, descrivi un'eroina originale invece di un membro reale. Scrivi “un'eroina immaginaria con una giacca varsity aderente” o “un'eroina originale con una postura decisa e sicura”. Non scrivere “il membro delle IVE” né nominare una persona reale.
Aggiungi costume, oggetti di scena e colore
Il costume è uno dei controlli più potenti di cui disponi nella modalità testo-a-video. Sii specifico su tipo di capo, vestibilità, materiale e colore. “Giacca bomber argentata sopra un crop top nero, pantaloni cargo a vita alta e stivali massicci” offre al modello più elementi su cui lavorare rispetto a “outfit cool”.
Anche gli oggetti di scena aiutano, ma tienili semplici. Un singolo oggetto come una piccola pistola di scena, un gesto finger-gun, una borsa a tracolla o un fermaglio per capelli è più facile da generare rispetto a una moltitudine di oggetti. Se vuoi l'effetto della coreografia finger-gun / point, descrivi il gesto direttamente: “indica la camera con un gesto finger-gun, poi porta il braccio di scatto di lato”. Tienilo come indicazione di movimento, non come dichiarazione di una coreografia ufficiale.
Descrivi viso e capelli come un design originale
Per i personaggi di fantasia, descrivi viso e capelli come scelte di design. “Capelli neri corti con frangia netta”, “una mascella affilata”, “occhi castani caldi” o “una piccola cicatrice sopra un sopracciglio” sono dettagli pratici. Evita di descrivere le sembianze di una persona reale. Evita anche frasi vaghe come “viso perfetto”, perché non dicono al modello cosa disegnare.
Se il personaggio indossa trucco, trattalo come parte del design: “eyeliner grafico”, “labbra lucide” o “un leggero highlight glitterato”. Questi dettagli possono risultare chiari in una clip breve.
Aggiungi espressione e micro-movimenti
Le clip brevi traggono vantaggio da un'espressione chiara e uno o due piccoli movimenti. “Un mezzo sorriso sicuro”, “uno sguardo concentrato”, “un rapido sollevamento del sopracciglio” o “un rapido scatto della testa” possono reggere una clip di 5–12 secondi. Abbina l'espressione a un'azione semplice: fare un passo avanti, indicare, girarsi o sistemare una giacca.
Come descrivere la scena
Una volta che il personaggio è chiaro, descrivi la scena a livelli: luogo, momento della giornata, illuminazione, movimento dello sfondo, angolazione della camera e formato. Mantieni lo sfondo abbastanza semplice da lasciare il personaggio al centro dell'attenzione.
Prepara l'ambiente
Inizia con un luogo che abbia contrasto visivo. “Un tetto bagnato dalla pioggia di notte”, “uno studio bianco con un unico riflettore” o “un vicolo illuminato al neon con asfalto bagnato” sono facili da visualizzare. Poi aggiungi uno o due dettagli di sfondo, non dieci. Qualche elemento in movimento, come vapore che si disperde o luci di auto che passano, può rendere la scena viva senza affollare il personaggio.
Scegli camera e inquadratura
I prompt testo-a-video rispondono bene al linguaggio della camera. Usa termini come “piano medio”, “primo piano”, “inquadratura dal basso”, “carrellata” o “lento push-in”. Per l'output predefinito in 9:16, un piano medio verticale o un primo piano di solito funziona meglio di una composizione ampia in orizzontale. Se vuoi una clip in stile danza, scrivi “inquadratura verticale a figura intera” e lascia spazio sopra la testa per il movimento.
Aggiungi illuminazione e atmosfera
L'illuminazione cambia completamente la lettura di un personaggio. “Luce dura di contorno”, “luce morbida da studio”, “luce notturna blu fredda” o “luce pratica calda” sono utili. Parole legate all'atmosfera come “sicuro”, “teso” o “giocoso” dovrebbero sostenere la descrizione visiva, non sostituirla. “Inquadratura dal basso con tono sicuro e luce dura di contorno” è più concreta di “atmosfera cool”.
Un modello pratico di prompt
Usa una struttura numerata nei tuoi appunti prima di incollare il prompt finale nello studio. Questo evita che personaggio e scena si fondano in un paragrafo confuso.
- Ruolo del personaggio: “Un'eroina immaginaria”.
- Silhouette e costume: “Corporatura atletica, giacca varsity argentata, pantaloni cargo neri, stivali massicci”.
- Viso e capelli: “Capelli neri corti con frangia netta, eyeliner grafico, mezzo sorriso sicuro”.
- Azione e gesto: “Avanza, indica la camera con un gesto finger-gun, poi si gira leggermente”.
- Scena e illuminazione: “Tetto bagnato dalla pioggia di notte, insegne al neon dietro di lei, luce dura di contorno”.
- Camera e formato: “Piano medio verticale, lento push-in, 9:16, 8 secondi”.
Questo è un punto di partenza, non una formula. Se il risultato è troppo caotico, rimuovi dettagli di sfondo. Se il personaggio sembra generico, aggiungi un dettaglio distintivo al costume o ai capelli. Se il movimento non è chiaro, semplifica l'azione riducendola a un solo verbo.
I livelli del prompt in sintesi
| Livello | Cosa scrivere | Frase di esempio | | ---------------- | ---------------------------------------------------- | -------------------------------------------------------- | | Personaggio | Ruolo, corporatura, silhouette | “Un giovane eroe immaginario dalla corporatura atletica” | | Costume | Tipo di capo, vestibilità, colore, materiale | “Giacca varsity argentata sopra un crop top nero” | | Viso e capelli | Dettagli del design originale | “Capelli neri corti, frangia netta, eyeliner grafico” | | Azione | Un gesto o movimento chiaro | “Indica la camera, poi si gira” | | Scena | Luogo, ora, movimento dello sfondo | “Tetto al neon di notte, pioggia leggera” | | Camera | Dimensione dell'inquadratura, angolazione, movimento | “Piano medio verticale, lento push-in” | | Luce e atmosfera | Qualità e tono della luce | “Luce dura di contorno, tono sicuro” |
Risoluzione, durata e crediti
L'output testo-a-video è in 9:16 per impostazione predefinita e dura 5–12 secondi. Una clip standard da 12 secondi in 720p costa 35 crediti. Una clip da 12 secondi in 480p costa 20 crediti, mentre una clip da 12 secondi in 1080p costa 90 crediti. I crediti partono da $9.90. I render non riusciti vengono rimborsati. I pacchetti una tantum non scadono mai; i crediti mensili scadono alla fine del mese di fatturazione e i crediti annuali sono validi per l'anno di fatturazione. Controlla i prezzi per i pacchetti attuali.
Per i prompt in stile danza o con molto movimento, la pagina della funzione è il riferimento migliore. Se vuoi creare una clip incentrata sulla coreografia a partire dalla descrizione di un personaggio, leggi come creare un video di danza con Looks Can Kill AI. Se preferisci partire da un'immagine che possiedi o che hai il permesso di usare, usa invece la modalità foto.
Esempio: una scena originale con un'eroina
Ecco un prompt compatto che puoi adattare senza usare le sembianze di nessuna persona reale:
Un'eroina immaginaria con una corporatura atletica, capelli neri corti con frangia netta, eyeliner grafico e un mezzo sorriso sicuro. Indossa una giacca varsity argentata sopra un crop top nero, pantaloni cargo a vita alta e stivali massicci. Avanza su un tetto bagnato dalla pioggia di notte, indica la camera con un gesto finger-gun, poi gira la spalla con uno sguardo deciso. Insegne al neon brillano dietro di lei, cade una pioggia leggera, luce dura di contorno, piano medio verticale, lento push-in, 9:16, 8 secondi.
Questo prompt descrive un personaggio e una scena originali. Non dichiara di includere la registrazione ufficiale, il video ufficiale o le sembianze dei membri. Inoltre non richiede il caricamento di una foto. Se in seguito decidi di usare una foto, ricorda che puoi caricare solo una tua foto o una foto di cui hai il permesso di utilizzo.
Domande frequenti
Posso usare la modalità testo-a-video senza caricare alcuna foto?
Sì. La modalità testo-a-video funziona a partire da una descrizione scritta. Puoi creare un personaggio e una scena di fantasia senza caricare una foto. Se passi alla modalità foto, puoi caricare solo una foto che possiedi o che hai il permesso di usare.
Posso descrivere un personaggio che somiglia a un membro delle IVE?
No. Mantieni il personaggio originale. Non descrivere le sembianze di un artista reale né usare lo studio per imitare un membro. Puoi fare riferimento a un'atmosfera generale come “eroina” o “gesto deciso di indicare”, ma il personaggio deve essere un tuo design di fantasia.
Lo studio include il brano o il video ufficiale di “Looks Can Kill”?
No. Looks Can Kill AI è indipendente e non è affiliato a IVE o Starship Entertainment. Non include la registrazione ufficiale, il video ufficiale o le sembianze dei membri. Il sito è uno studio di foto/testo-a-video basato su Seedance 2.0.
Quanto possono durare le clip e quale formato usano?
L'output è in 9:16 per impostazione predefinita e dura 5–12 secondi. Puoi scegliere 480p, 720p o 1080p. Una clip standard da 12 secondi in 720p costa 35 crediti; una da 12 secondi in 480p costa 20 crediti; una da 12 secondi in 1080p costa 90 crediti.
Cosa succede se un render non riesce?
I render non riusciti vengono rimborsati. I pacchetti una tantum non scadono mai. I crediti mensili scadono alla fine del mese di fatturazione e i crediti annuali sono validi per l'anno di fatturazione.
Dove posso vedere lo studio testo-a-video e i prezzi?
Apri lo studio per iniziare un prompt e visita i prezzi per i pacchetti di crediti e i dettagli aggiornati.
Guide correlate
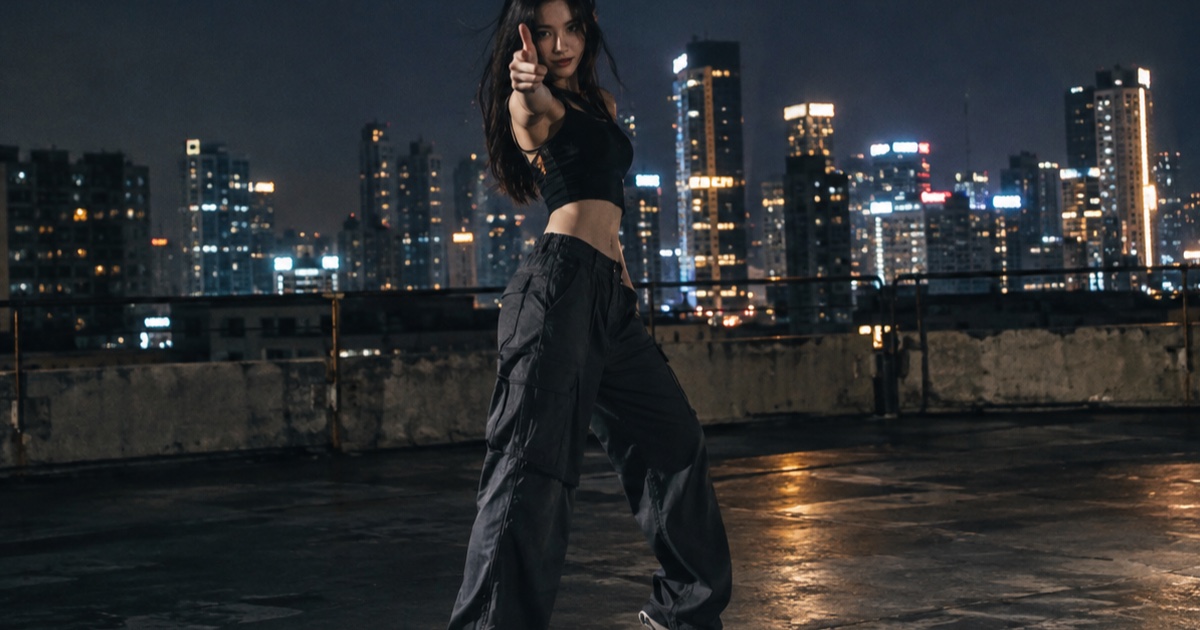
Che cos’è davvero il trend Looks Can Kill AI di IVE
Una guida pratica all’uscita di Looks Can Kill di IVE, al concept girl-hero, ai video da foto a danza creati dai fan e a dove si colloca lo studio indipendente Looks Can Kill AI.
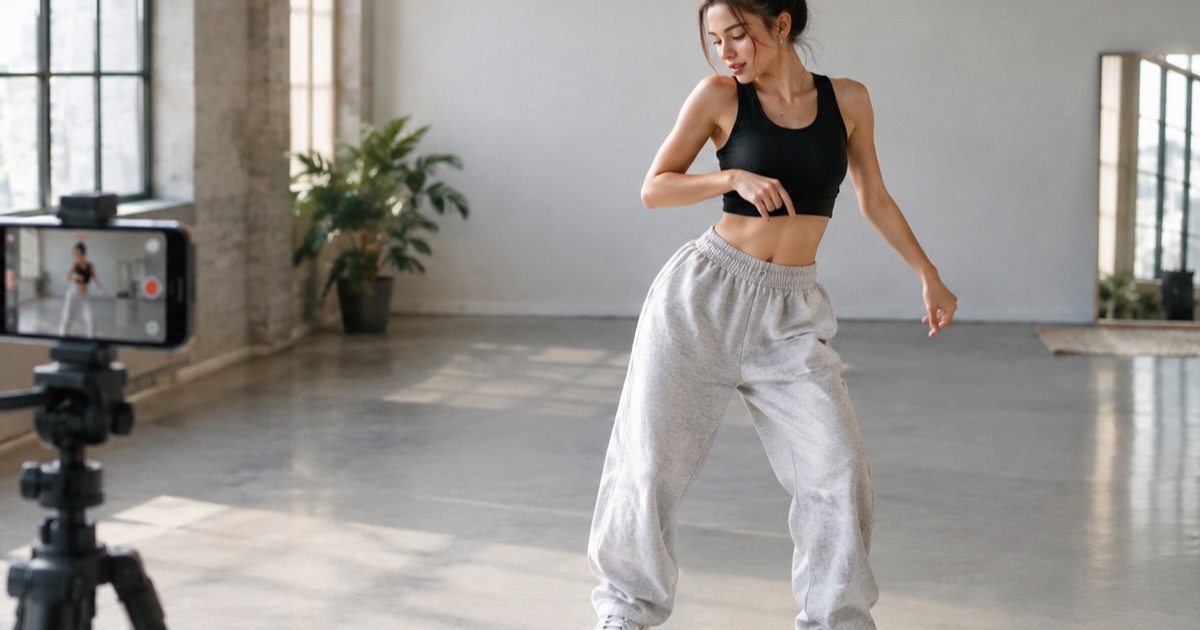
Come realizzare una clip dance verticale hero-point da 12 secondi partendo da una sola foto
Un tutorial pratico passo passo per trasformare una foto in una clip dance hero-point in 9:16 con Looks Can Kill AI — consigli sulla foto di partenza, prompt di movimento, costi in crediti e note sull'esportazione.
Come scrivere un prompt di danza hero-point per Looks Can Kill AI
Una guida pratica ai prompt per l’atmosfera della danza hero-point di “Looks Can Kill” delle IVE: blocco del soggetto, scena, una sola azione, camera ed esclusioni, con cinque prompt di esempio completi.